机器学习基础
概论
机器学习(Machine Learning)是人工智能的一个分支,它的核心思想是让计算机从数据中自动学习规律,而不是由人手工编写规则。
监督学习(Supervised Learning)
监督学习是指:训练数据中每个样本都带有"标准答案"(标签 label),模型通过学习输入特征 X 到输出 y 的映射关系,从而对新数据做出预测。
形式化地说:给定训练集
- 回归(Regression): 预测连续数值
- 分类(Classification):预测离散类别
无监督学习(Unsupervised Learning)
无监督学习是指:训练数据没有标签(没有"标准答案"),模型只能从数据本身的分布和结构中发现规律。
形式化地说:给定训练集
- 聚类(Clustering):把相似样本归为一组,组内相似、组间差异大。如用户分群、新闻聚合、图像分割。
- 降维(Dimensionality Reduction):把高维数据压缩到低维,保留主要信息。目的:去噪、加速计算、可视化、缓解"维度灾难"。
- 异常检测(Anomaly Detection):找出与大多数样本明显不同的"离群点"。如信用卡欺诈检测、设备故障预警。
- 关联规则挖掘(Association Rules):发现事物之间的共现关系。
回归(Regression)
一元线性回归 Linear Regression with One Variable
线性回归的模型表示为
:权重, 每增加 1 个单位, 平均变化 :偏置, 时的预测值 - (x
, y ):表示第 个训练样本
只有一个特征
代价函数 Cost Function
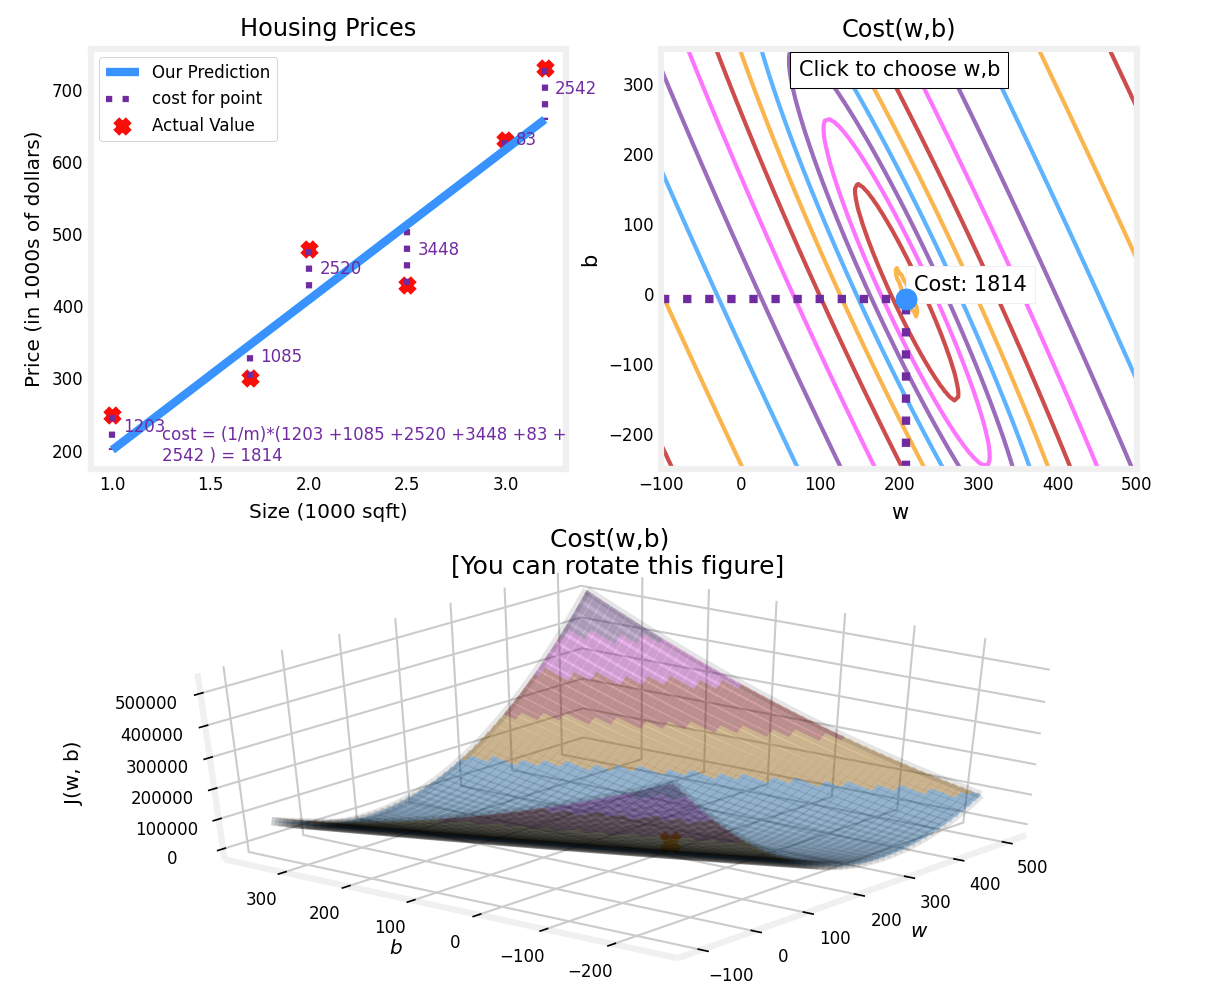
Cost Function是机器学习中用来衡量模型预测结果与真实结果之间差距的函数。用来评价模型的好坏
一元线性回归中我们选择的参数
使用平方误差代价函数(Squared Error Cost Function) 作为代价函数,公式为:
其中:
是我们使用参数 对第 个样本的预测值。 是目标值与预测值之间的平方差。 - 将所有
个样本的这些差值求和,再除以 2m,即得到代价。
NOTE
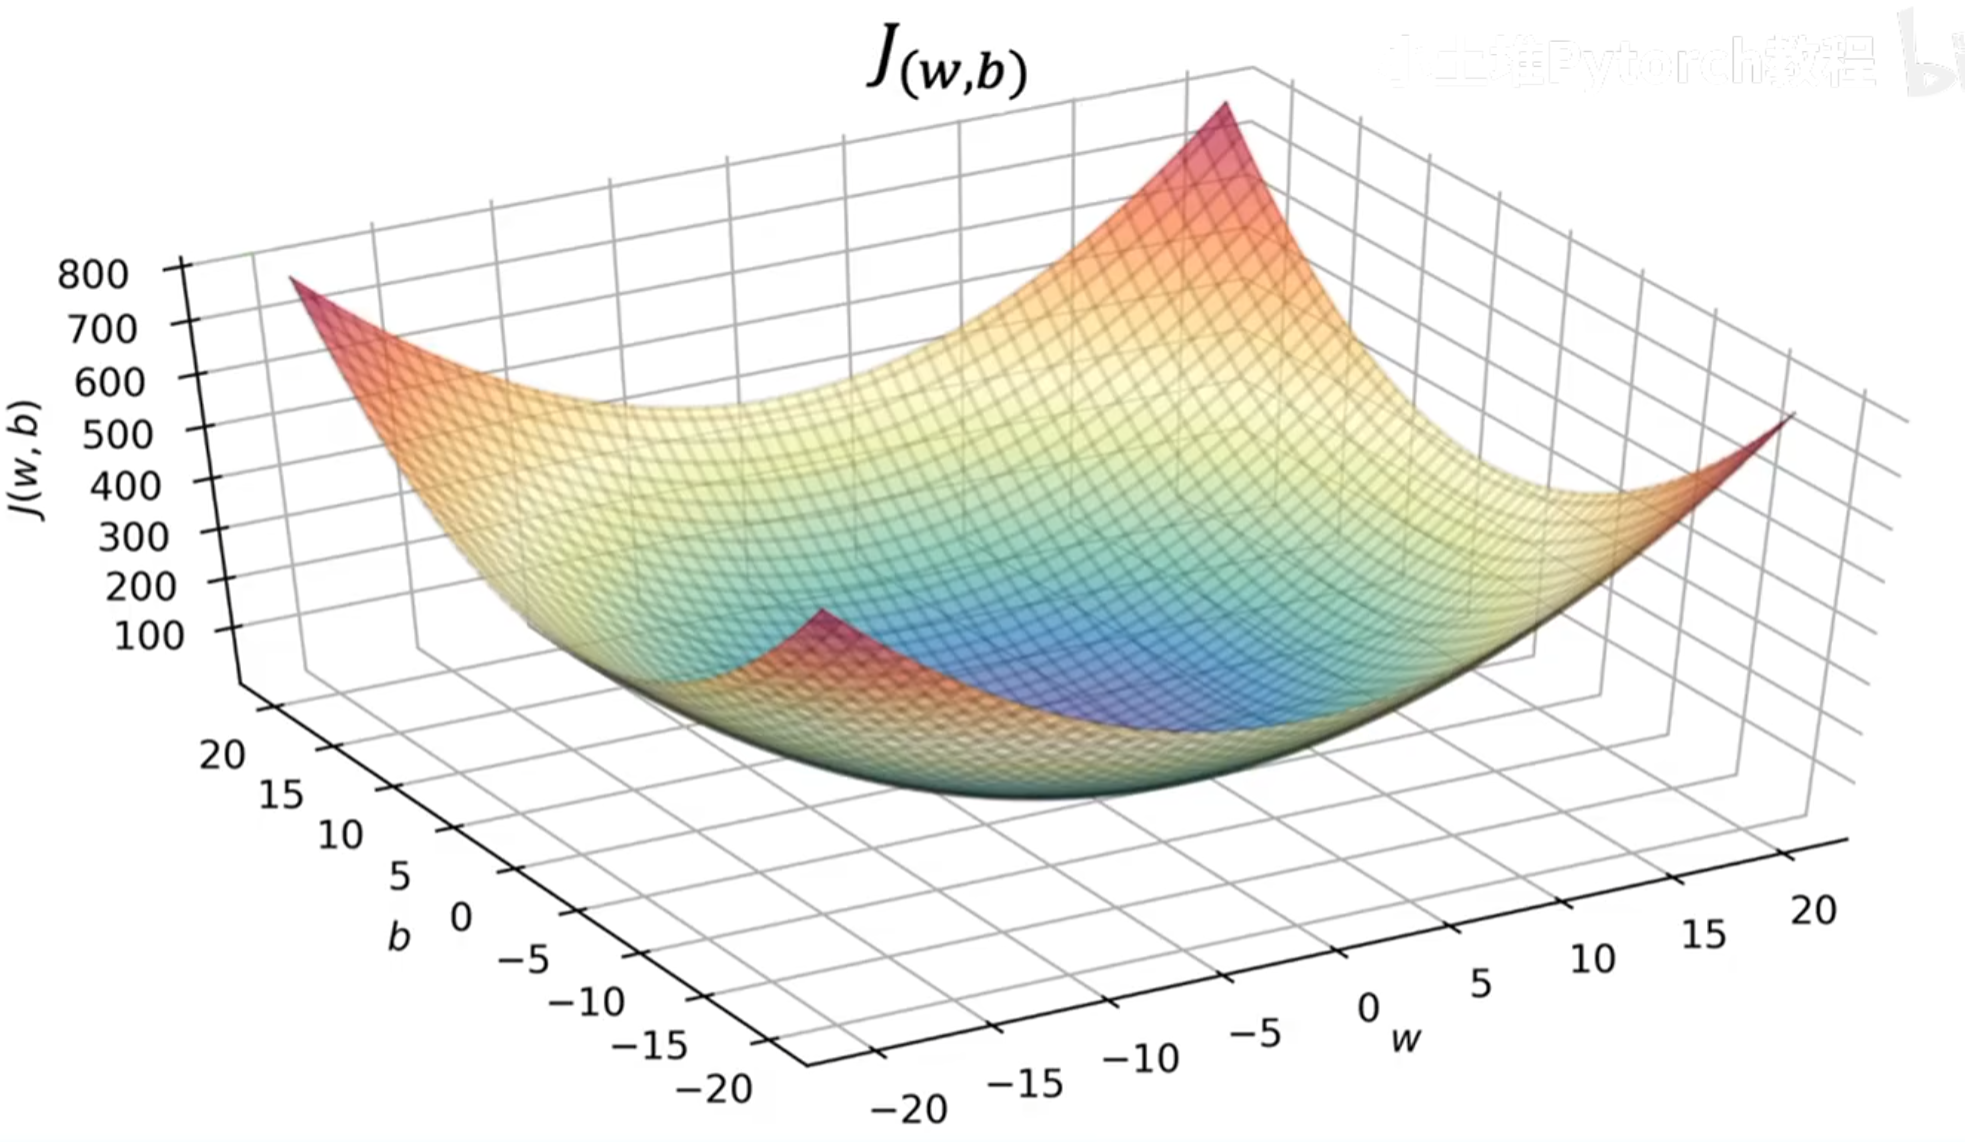
损失函数对损失值做平方处理这一特性,能保证 “误差曲面” 呈汤碗状的凸曲面。该曲面始终存在最小值,沿所有维度的梯度方向迭代都能找到这个最小值。
梯度下降 Gradient Descent
求解最小二乘法就是在线性回归中,它对应的就是让 Cost Function 最小。这个优化问题可以通过解析方法(正规方程)直接求解,也可以通过迭代优化方法(如梯度下降)求解。在机器学习实践中,当数据规模较大或模型复杂时,通常更倾向使用梯度下降
梯度下降背后的思想是:开始时我们随机选择一个参数的组合,计算代价函数,然后我们寻找下一个能让代价函数值下降最多的参数组合。我们持续这么做直到到到一个局部最小值(local minimum)。因为我们并没有尝试完所有的参数组合,所以不能确定我们得到的局部最小值是否便是全局最小值(global minimum),选择不同的初始参数组合,可能会找到不同的局部最小值。
代价函数:
批量梯度下降(batch gradient descent)算法的公式为:
梯度的定义为:
在梯度下降中,在计算微分求导项时,我们需要进行求和运算,所以,在每一个单独的梯度下降中,我们最终都要计算所有个训练样本求和。因此,批量梯度下降法这个名字说明了我们需要考虑所有这一"批"训练样本,而事实上,有时也有其他类型的梯度下降法,不是这种"批量"型的,不考虑整个的训练集,而是每次只关注训练集中的一些小的子集,称为小批量梯度下降(Mini-batch Gradient Descent)
一元回归代码实现
import numpy as np
import matplotlib.pyplot as plt

x = np.array([])
y = np.array([])

with open("./dataset/ex1data1.txt", "r", encoding="utf-8") as f:
    for line in f.readlines():
        data = line.strip().split(',')
        x = np.append(x, float(data[0]))
        y = np.append(y, float(data[1]))

m = len(x)
# print(np.hstack([np.ones((m, 1)), x.reshape(-1, 1)]))
X = np.c_[np.ones(m), x]

n = 5000
a = 0.01
# [b, w]
W = np.zeros((2, 1))
# print(W)
for _ in range(n):
    y_pred = X @ W
    # print(X.shape)
    # print(W.shape)
    grad = X.T @ (y_pred - y.reshape(-1, 1))
    W = W - (grad / m) * a

print(W)
plt.scatter(x, y)
x_plot = np.array([np.min(x), np.max(x)])
y_plot = W[0] + x_plot * W[1]
plt.plot(x_plot, y_plot, c="m")
plt.show()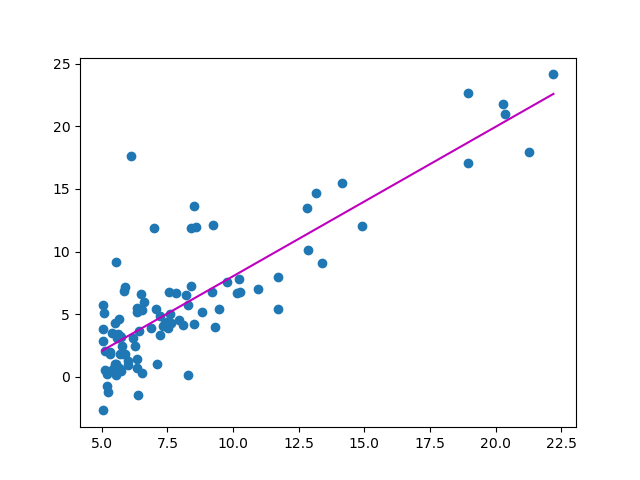
多元线性回归 Multiple Linear Regression
模型表示为:
向量表示为 dot product
代价函数
梯度下降算法
特征数量为n, 参数
特征缩放与标准化
当不同自变量取值范围相差较大时,绘制的等高线图上的椭圆会变得瘦长,而梯度下降算法收敛将会很慢,因为每一步都可能会跨过这个椭圆导致振荡。此时,我们需要把所有自变量进行缩放、标准化,使其落在 -1 到 1 之间。
NOTE
标准化改变数据分布,让均值为 0、标准差为 1;归一化改变数据范围,把数据压缩到固定区间。
在机器学习中,标准化是更常用的手段,归一化的应用场景是有限的。因为「仅由极值决定」这个做法过于危险,如果样本中有一个异常大的值,则会将所有正常值挤占到很小的区间,而标准化方法则更加「弹性」,会兼顾所有样本
- 特征缩放(Feature scaling):
- 简单版:将每个正特征除以其最大值 ,结果 [0, 1]
- 通用版:
(x - min) / (max - min),适用于任意特征,结果 [0, 1] - 两种方式都将特征归一化到 -1 到 1 范围内。
- 均值归一化(Mean normalization):
,结果约 [-0.5, 0.5],数据居中 - Z-score 标准化(Z-score normalization):
, 为某个特征,结果均值 0、方差 1,最常用,其中
其中
是第 个特征的均值, 是标准差。
WARNING
此外,线性回归并不适用于所有情形,有时我们需要曲线来适应我们的数据,这时候我们也要对特征进行构造,如二次函数、三次函数、幂函数、对数函数等。构造后的新变量就可以当作一个新的特征来使用,这就是多项式回归(Polynomial Regression)。新变量的取值范围可能更大,此时,特征缩放就非常有必要!
多元回归代码实现
import numpy as np
import matplotlib.pyplot as plt

x = []
y = []

with open("./dataset/ex1data2.txt", "r", encoding="utf-8") as f:
    for line in f.readlines():
        data = list(map(float, line.strip().split(',')))
        x.append(data[:-1])
        y.append(data[-1])

x = np.array(x)
y = np.array(y)
# print(x.shape, y.shape)

# 标准化
u = np.mean(x, axis=0)
sigma = np.std(x, axis=0)
x = (x - u) / sigma
# print(x)

m, n = x.shape
X = np.c_[np.ones(m), x]
W = np.zeros((n + 1, 1))

niter = 1500
a = 0.01
J_history = []
for i in range(niter):
    y_pred = X @ W
    error = y_pred - y.reshape(-1, 1)
    grad = X.T @ error
    W = W - a * (grad / m)
    J_history.append(np.sum(error ** 2) / (2 * m))

print(W)
# 面积,房间数
input_data = np.array([1650, 3])
input_data = (input_data - u) / sigma
pred = np.r_[np.ones(1), input_data] @ W
print(pred.sum())


# plot the convergence graph
plt.plot(np.arange(len(J_history)), J_history)
plt.xlabel('Number of iterations')
plt.ylabel('Cost J')
plt.show()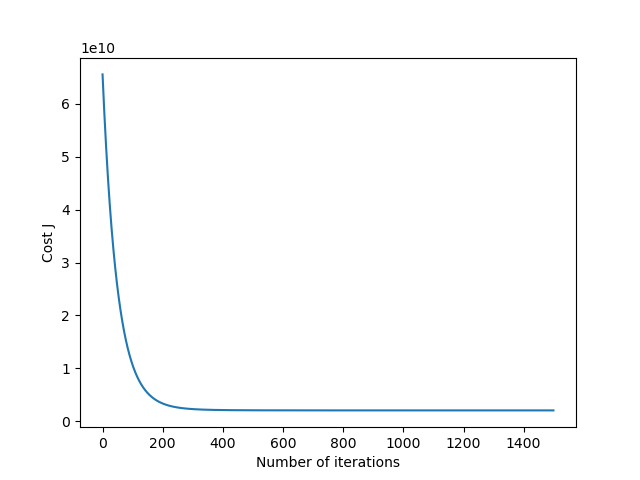
分类(Classification)
在分类问题中,我们尝试预测的结果是否属于某一个类,最基础的就是二元的分类问题,更为复杂的则是预测多元的分类问题。
如果用线性回归来解决,即用一条直线拟合结果,当预测值大于阈值时归为正向类,反之归为负向类。然而,当阈值确定时,「反常样本」用于拟合直线时会对其决策边界造成一定偏移,以至于正常样本被归为错误类别。
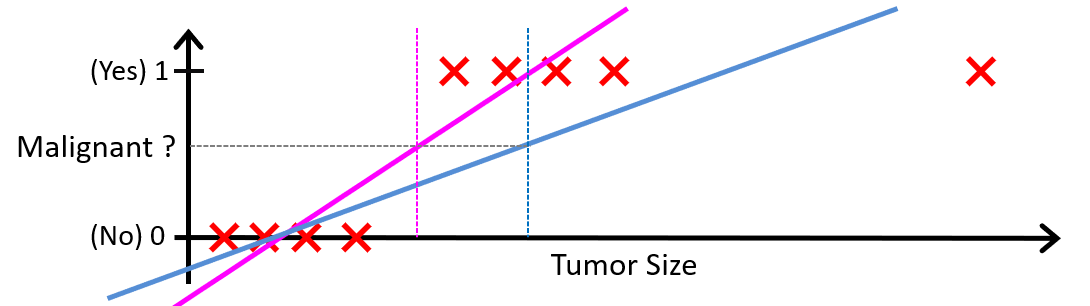
逻辑回归 Logistic Regression
模型
线性回归和逻辑回归都属于广义线性模型(Generalized Linear Model)的特殊形式。但由于逻辑函数(Losistic Function,也叫 Sigmoid 函数)将结果映射到 Bernoulli 分布,因此逻辑回归更常用于分类问题。
模型表示为:
if
if
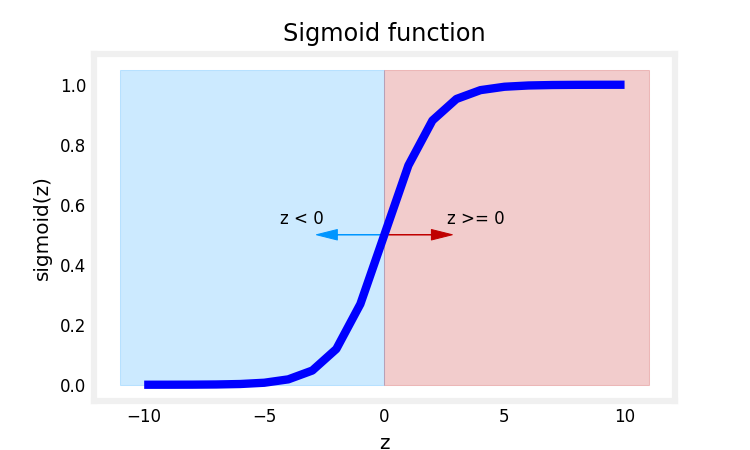
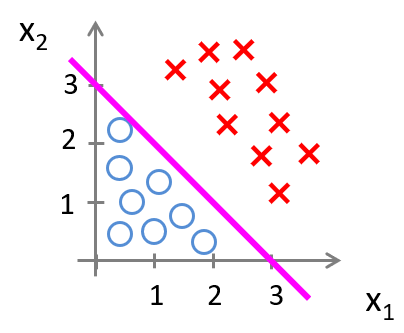
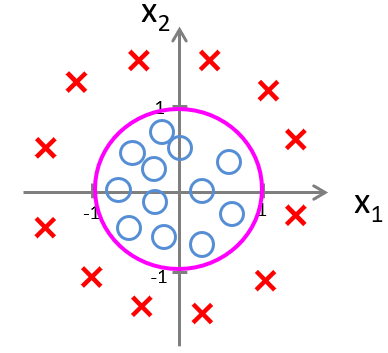
代价函数
从训练集中拟合逻辑回归的参数
IMPORTANT
本文定义:损失用于衡量单个样本与其目标值之间的差异,而代价则是训练集上所有损失的综合度量
在线性回归中我们使用平方误差函数作为损失函数,如果继续使用会造成损失曲面非凸(坑坑洼洼很多局部最优),梯度下降会卡住。
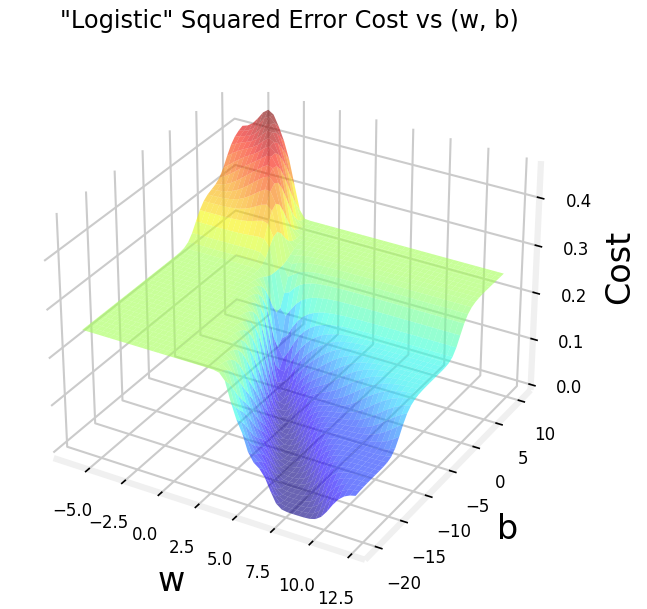
广义上定义的代价函数如下
在逻辑回归中,我们使用二元交叉熵作为代价函数,而交叉熵与 Sigmoid复合后,始终保持凸性
为模型预测, 为第 个标签 where function is the sigmoid function.
写成一个式子后如下
其中
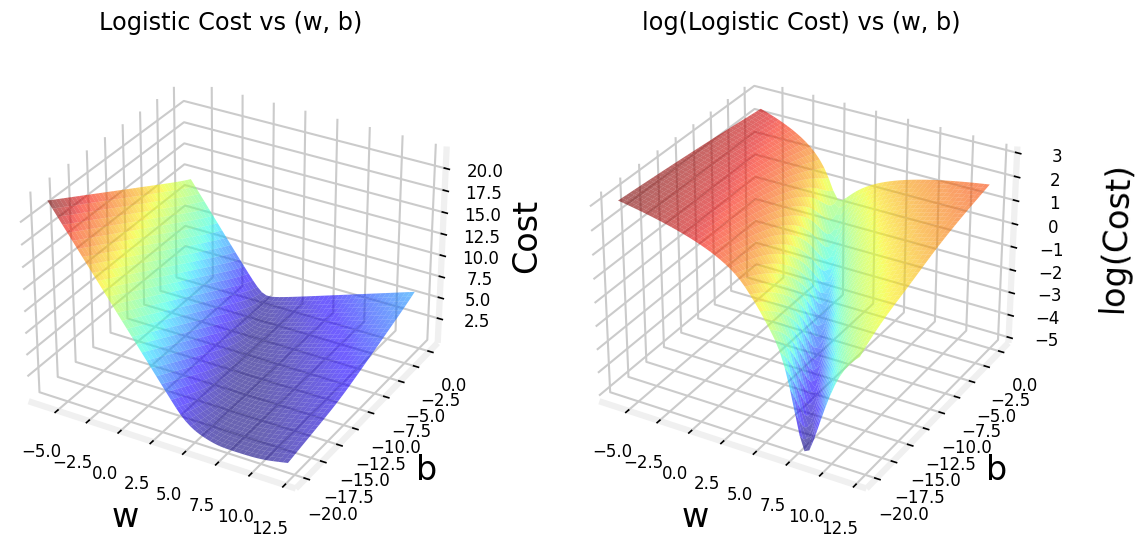
梯度下降
对代价函数求偏导后和线性回归的偏导形式完全相同,但
代码实现
import numpy as np
import matplotlib.pyplot as plt

data = np.loadtxt("./dataset/ex2data1.txt", delimiter=",")

# print(type(data))
x = data[:,0:-1]
y = data[:,-1].reshape(-1, 1)
m, n = x.shape

x = (x - x.mean(axis=0)) / x.std(axis=0)
X = np.c_[np.ones(m), x]


a = 0.01
niter = 10000
W = np.zeros((n + 1, 1))
J_history = []

for _ in range(niter):
    z = X @ W
    y_pred = 1 / (1 + np.exp(-z))
    grad = X.T @ (y_pred - y)
    W = W - a * (grad / m)

    cost = -np.mean(y * np.log(y_pred) + (1 - y) * np.log(1 - y_pred))
    J_history.append(cost)


print(W)

fig, (p1, p2) = plt.subplots(1, 2,figsize=(12, 5))
neg_pos = np.where(y == 0)[0]
pos_neg = np.where(y == 1)[0]
p1.scatter(x[neg_pos, 0], x[neg_pos, 1], c='red')
p1.scatter(x[pos_neg, 0], x[pos_neg, 1], c='blue')
p1.set_xlabel('feature 1 - norm')
p1.set_ylabel('feature 2 - norm')
x_plot = np.linspace(x[:, 0].min(), x[:, 0].max(), 100)
p1.plot(x_plot, (-W[1] * x_plot - W[0]) / W[2])

p2 = plt.subplot(1, 2, 2)
p2.plot(np.arange(len(J_history)), J_history)
p2.set_xlabel('Number of iterations')
p2.set_ylabel('Cost J')
plt.show()
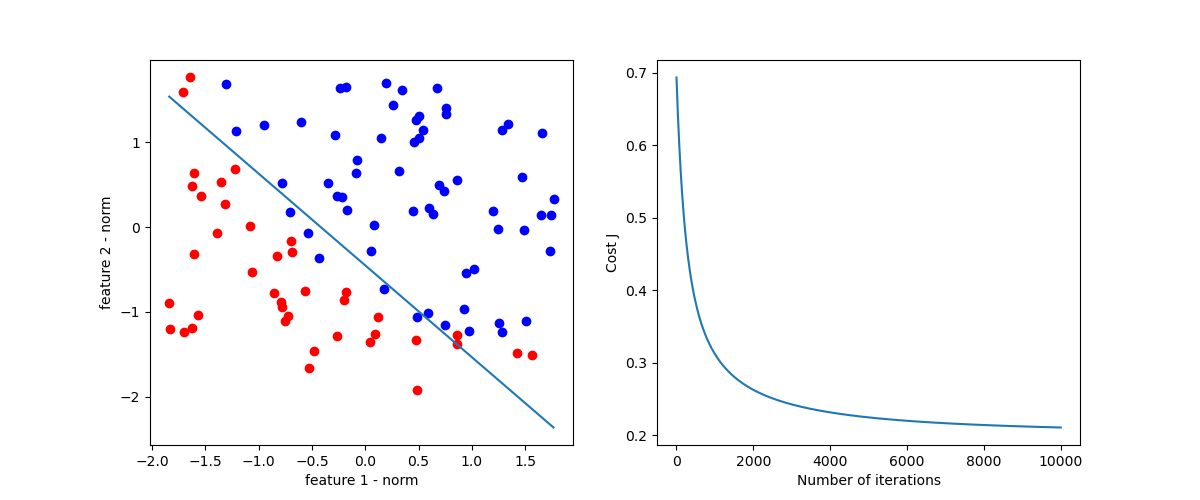
决策边界和收敛结果如图
决策树 Decision Tree
决策树用一连串 if-else 判断把数据逐步细分,最终把每个样本分到一个"最纯"的叶子里。
每个内部节点是一次特征测试,每条分支是一个取值,每个叶节点是最终预测(分类:多数类;回归:均值)。学习过程即挑最有效的特征不断划分,直到子集足够"纯"。
模型算法
- 若当前节点样本全属同一类(或特征用完/达到限制)→ 设为叶节点
- 否则:在所有特征的所有划分点中,选"纯度提升最大"的划分
- 按该划分把数据分到各子节点,对每个子节点递归执行 1-3
信息熵与信息增益
信息熵(Entropy): 衡量"不纯"的程度
:第 类样本占比 - 越纯熵越小:全是同一类 →
;二分类各占一半 → (最大)
信息增益(Information Gain): 用特征 a 划分后,熵下降了多少
条件熵: 按分支样本占比加权平均各子集的熵。增益越大,划分越好。
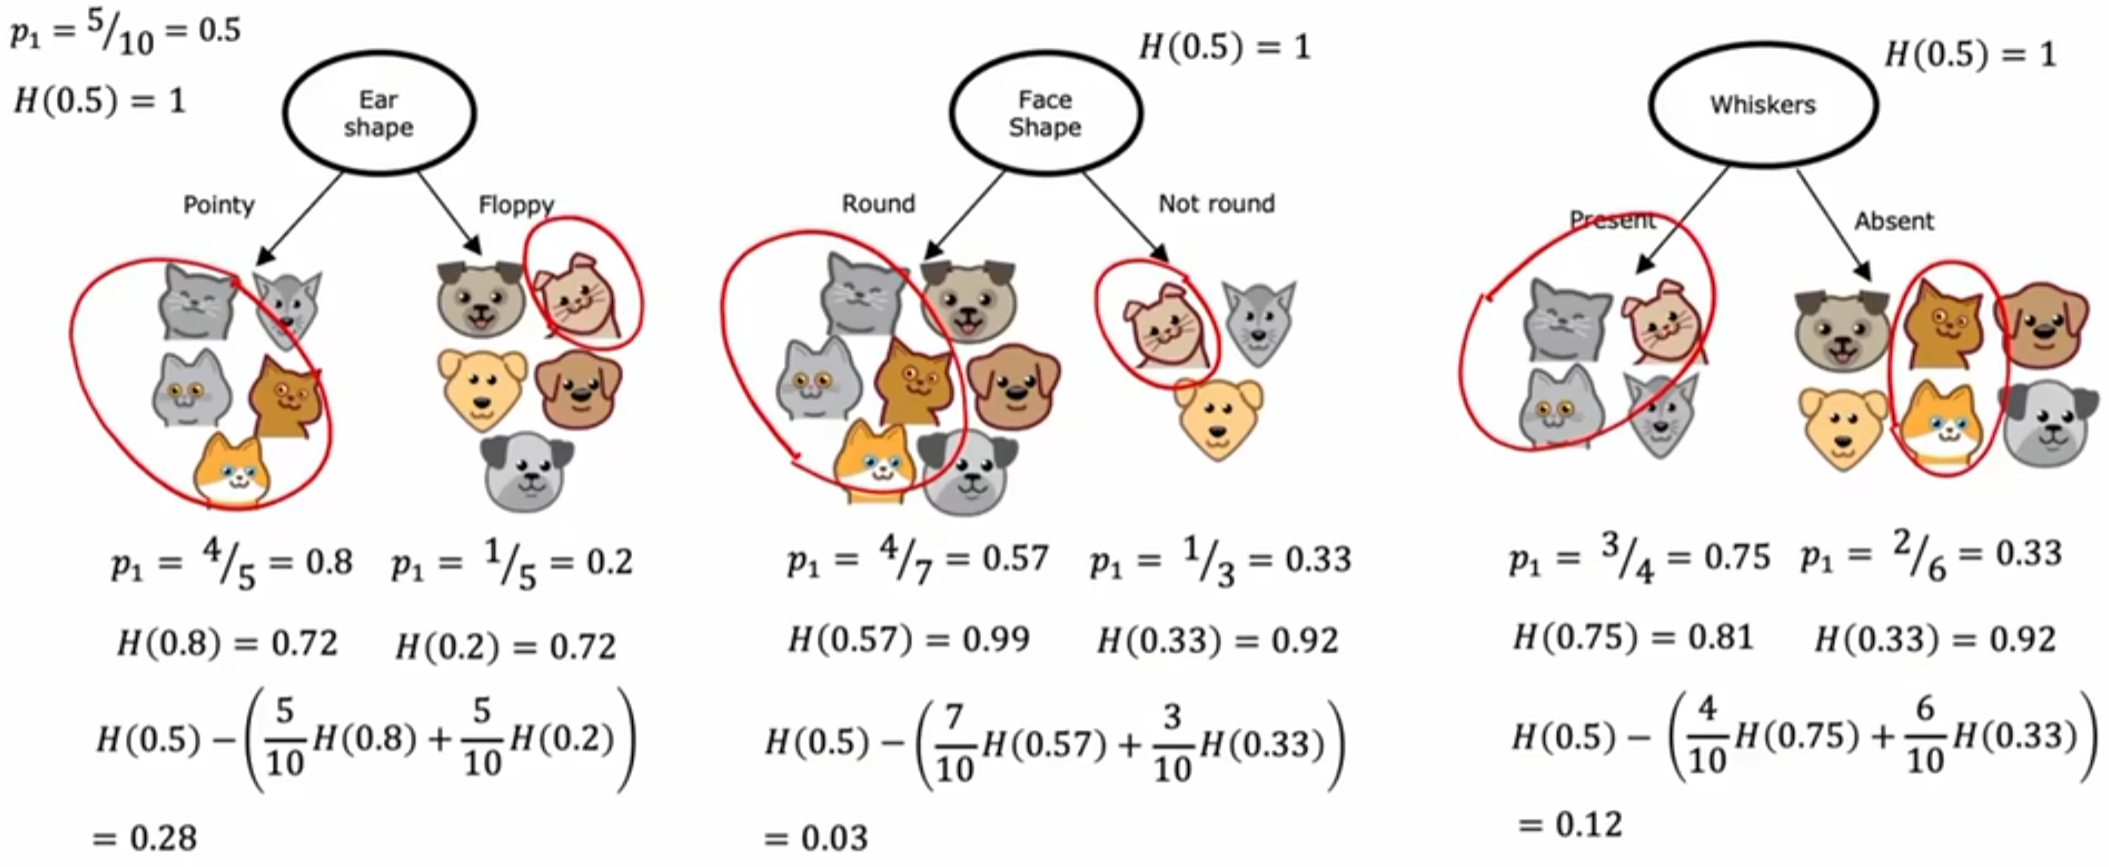
示例
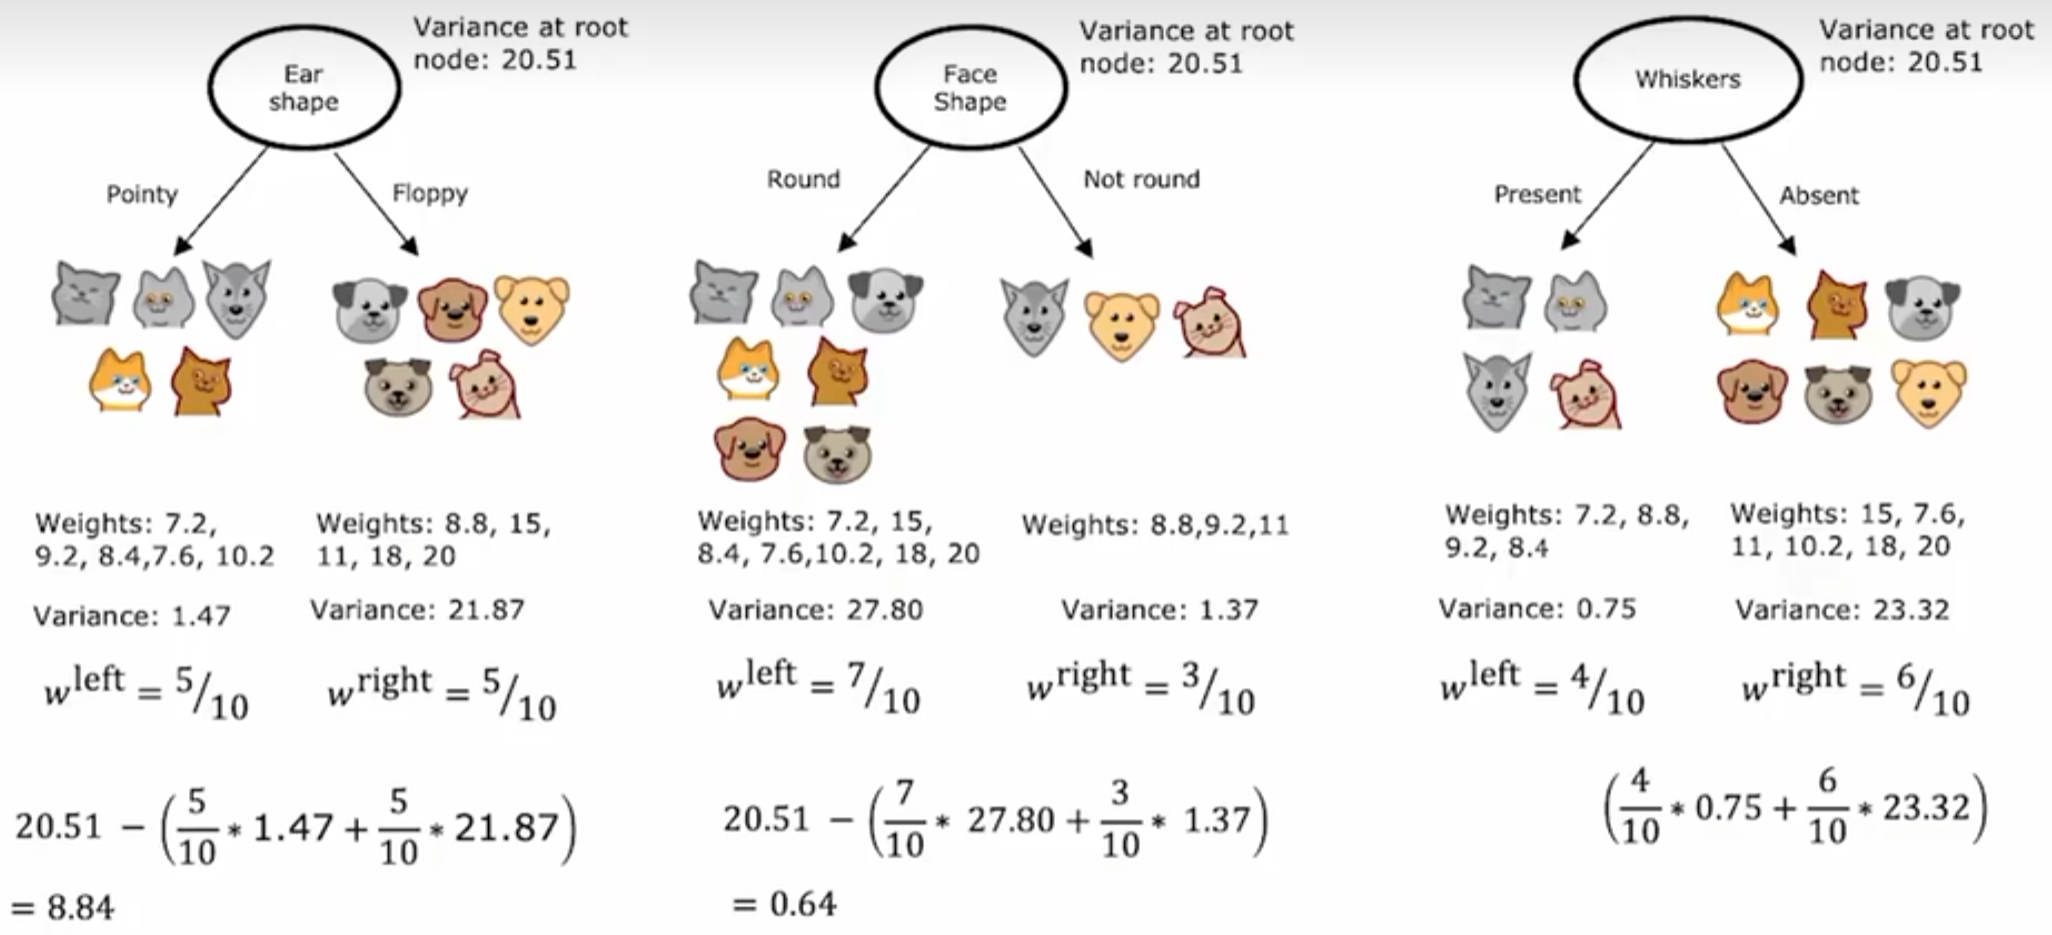
推广为回归算法(CART 回归树)
- 叶节点输出:该叶子样本的目标均值
- 划分标准:不用熵/基尼,而是最小化平方误差的下降
随机森林 Random Forest
决策树缺点
- 极易过拟合:树深了就把噪声背下来(训练集 100%,测试集崩)
- 不稳定:数据微小的变化能长出完全不同的树
- 贪心:每次只做局部最优划分,看不到全局
单棵树剪枝能缓解,但治标不治本。不只依赖一个模型,而是把多个模型组合起来,让最终预测更稳定、更准确,这就是集成学习。
| Bagging | Boosting | |
|---|---|---|
| 树的关系 | 并行独立训练 | 串行,后树纠正前树错误 |
| 数据采样 | 有放回 Bootstrap 抽样 | 全量数据,但错误样本加权 |
| 降低什么 | 主要降方差(过拟合) | 主要降偏差(欠拟合) |
| 代表算法 | 随机森林 | AdaBoost、GBDT、XGBoost |
算法思想
- 样本随机(Bootstrap):从
个样本中有放回地抽 次,得到一棵树的训练集。每棵树用不同的采样集训练。 - 特征随机:每个节点分裂时,只从随机选出的
个特征里挑最优,而不是从全部 个特征里挑 - 分类默认
,回归默认
- 分类默认
重复 B 次(B 棵树):
    ① Bootstrap 采样得到训练子集
    ② 种一棵"自由生长"的决策树(不剪枝或轻剪枝):
         每个节点分裂时,随机抽 k 个特征,从中选最优划分
预测:
    分类 → B 棵树投票,多数类获胜
    回归 → B 棵树预测取平均
方差分析
设每棵树预测的方差为
两个启示:
- 树越多(
大),第二项越小——但第一项 是地板,树再多也降不下去 - 决定地板的是树间相关性
——随机特征子集正是为了压低
所以随机森林的两条优化路线:加树数量(治标,有上限)、降树间相关(治本,靠特征随机)。
- 保留深树的强拟合能力,用大量“彼此不太相同”的树做平均,降低方差,把不稳定性消掉。
GBDT / XGBoost
**GBDT(Gradient Boosting Decision Tree,梯度提升决策树)**基本思想是:一棵树一棵树地训练,后面的树专门修正前面模型犯的错误。GBDT 是一种算法思想,XGBoost 是对 GBDT 思想做了更强工程化和数学优化的实现。
GBDT算法思想
第 1 棵树: 用原始数据训练 → 有一批样本预测错了
第 2 棵树: 把重点放在第 1 棵树预测错的样本上 → 纠正部分错误
第 3 棵树: 再重点照顾前两棵还搞不定的样本 → 继续纠错
...
最终预测 = 所有树的加权求和
GBDT 每一轮(第
对于平方误差损失
1. 初始化: F₀(x) = 所有 y 的均值(或常数 c 最小化损失)
2. 重复 M 轮:
   a. 计算每个样本的负梯度
   b. 用 (x_i, r_i) 训练一棵浅树(回归树),叶子节点输出使损失最小的值
   c. 更新: F_m(x) = F_{m-1}(x) + η · 树_m(x)     (η 是学习率,每棵树只迈一小步。典型 η = 0.1)
3. 输出: F_M(x) = Σ η·树_m(x)
XGBoost 算法思想
XGBoost(eXtreme Gradient Boosting)在 GBDT 框架上做了大量工程与算法双重优化
- 目标函数升级:损失 + 正则
:叶子数, 控制"长一个新叶子要付出多大代价"(预剪枝) :叶权重 L2 正则 :第 个叶子的预测值
- 二阶泰勒展开:更快更准地找最优分裂
GBDT 只用一阶梯度(负梯度方向)。XGBoost 把损失在当前位置做二阶泰勒展开:
其中
SVM 支持向量机
#todo
KNN
#todo
欠拟合和过拟合
欠拟合(Underfitting) 就是模型过于简单,没有充分学习训练数据中的规律。
过拟合(Overfitting) 就是模型把训练数据学得“太细”了,甚至把数据中的噪声和偶然性也当成了规律。
可以从以下几个方面解决过拟合
- 从模型层面,可以通过 Early Stop、L1/L2 Regularization、Batchnorm、Dropout 等方法;
- 从特征层面,可以丢弃一些不能帮助我们正确预测的特征,通过手工筛选或 PCA 等降维方法;
- 从数据层面,可以获取更大的数据集,也可以进行数据增强(Data Augmentation),通过一定规则来扩充数据。
正则化(Regularization)
正则化是一种能够保留所有特征(不必降维而丢失信息)的有效解决过拟合的方法。其思想是在损失函数上加上某些规则(限制),限制参数的解空间,从而减少求出过拟合参数的可能性。
以线性回归为例,在代价函数后加入正则项
NOTE
根据正则项的形式,又可分为:二次正则项、一般正则项。二次正则项即为前文提到的形式,更一般的形式为
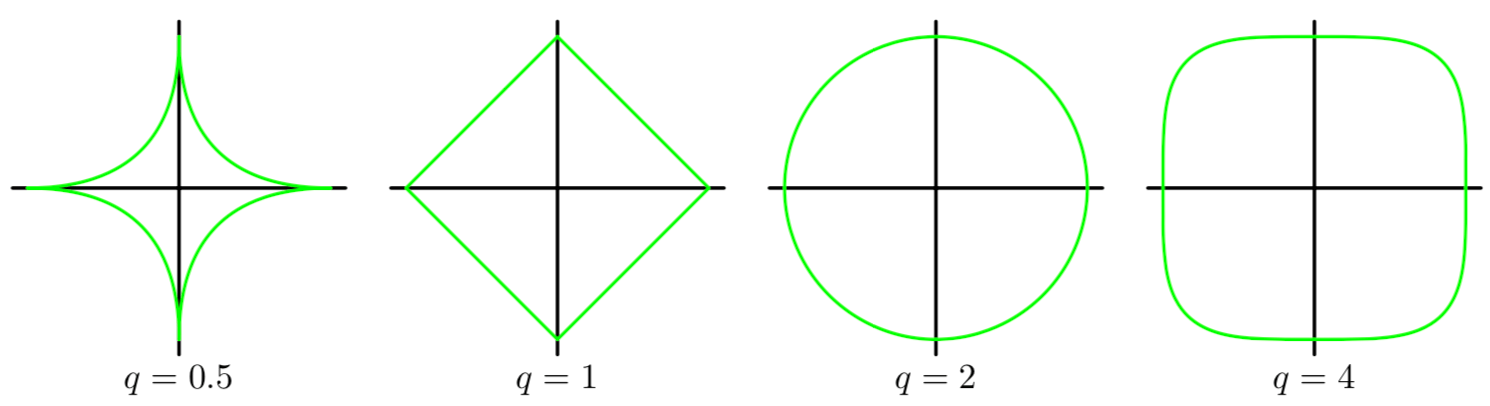
从几何空间上来看,损失函数的碗状曲面和正则化项的曲面叠加之后,就是我们要求极值的曲面。特别地,当
线性回归的正则化
含有正则化的代价函数为
梯度(求导后)
逻辑回归的正则化
含有正则化的代价函数为
梯度表达形式同线性回归
代码
import numpy as np
import matplotlib.pyplot as plt

data = np.genfromtxt("./dataset/ex2data2.txt", delimiter=',')
x = data[:,:-1]
x1 = data[:, 0]
x2 = data[:, 1]
y = data[:,-1].reshape(-1,1)

neg_pos = np.where(y == 0)[0]
pos_pos = np.where(y == 1)[0]
plt.scatter(x[neg_pos,0], x[neg_pos,1], c='red', marker='o')
plt.scatter(x[pos_pos,0], x[pos_pos,1], c='blue', marker='x')


m, n = x.shape
def map_feature(x1, x2):
    X = np.ones((len(x1),1))
    for i in range(1, 6 + 1):
        for j in range(0, i + 1):
            X = np.c_[X, (x1 ** j) * (x2 ** (i - j))]
    return X

X = map_feature(x1, x2) # (118, 28)
W = np.zeros((28, 1))
a = 0.01
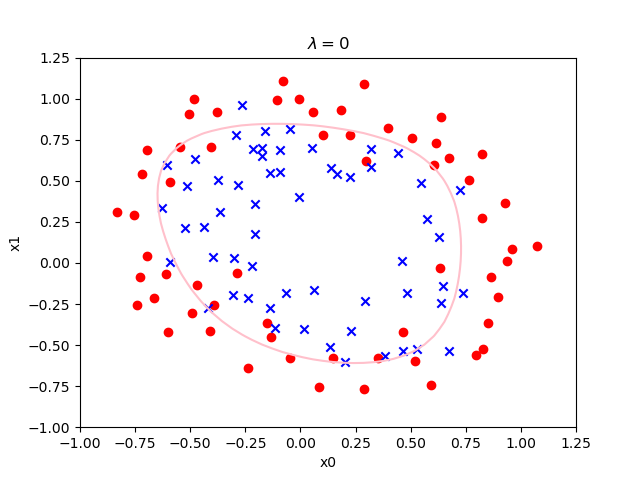
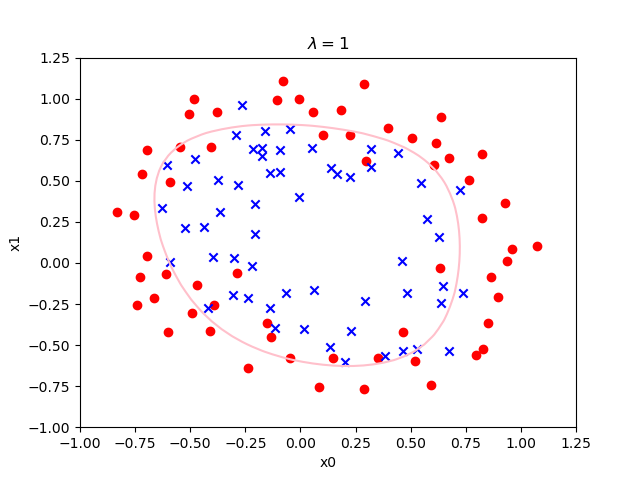
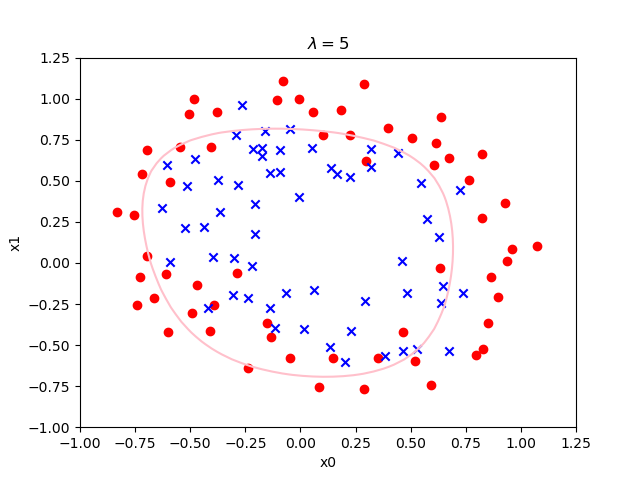
lamda = 5
niter = 10000

for _ in range(niter):
    Z = X @ W
    y_pred = 1 / (1 + np.exp(-Z))
    grad = X.T @ (y_pred - y) / m
    regular = (lamda / m) * np.r_[np.zeros((1,1)), W[1:, :]]
    W = W - a * (grad + regular)

print(W)
f1 = np.linspace(-1, 1.25, 50)
f2 = np.linspace(-1, 1.25, 50)
xv,yv = np.meshgrid(f1, f2)
Z = map_feature(xv.flatten(), yv.flatten()) @ W
plt.contour(xv,yv,Z.reshape(50, 50), levels=[0], colors='pink')
plt.title(f"$\lambda = {lamda}$")
plt.xlabel("x0")
plt.ylabel("x1")
plt.show()
增大正则化参数
深度学习(Deep Learning)
神经元
神经网络的灵感来自大脑神经元:接收多个输入信号,加权整合,超过阈值就"激活"输出。数学上一个人工神经元就是:
:权重(连接强度), :偏置(激活难易程度) :激活函数(非线性变换) - 一个神经元 + sigmoid 激活 = 逻辑回归。神经网络本质上就是把成千上万个"逻辑回归单元"层层堆叠、首尾相连。
如果没有激活函数(或用线性激活),无论堆多少层,整体都等价于一个单层线性模型(矩阵连乘仍是矩阵)。非线性激活是神经网络能拟合复杂函数的根本原因。
| 激活函数 | 公式 | 导数 | 特点 |
|---|---|---|---|
| ReLU | 隐藏层默认选择;缺点: | ||
| Leaky ReLU | 给负区间一个小斜率(如 0.01),解决死亡 ReLU | ||
| Sigmoid | 输出 (0,1) 可作概率;两端梯度≈0 导致梯度消失;现主要用于输出层(二分类) | ||
| Softmax | — | 多分类输出层专用,输出概率分布 |
神经网络与前向传播
- 单层感知机:单个神经元模型(只有输入层 + 输出层,无隐藏层,激活函数为跃迁函数,无法解决XOR线性不可分)
- 多层感知机(MLP):感知机叠加隐藏层 + 非线性激活 + 反向传播训练,即"经典的前馈全连接神经网络"
- 神经网络:一般由输入层、隐藏层、输出层构成——MLP 是最基础的一种,还有 CNN、RNN、Transformer 等变体
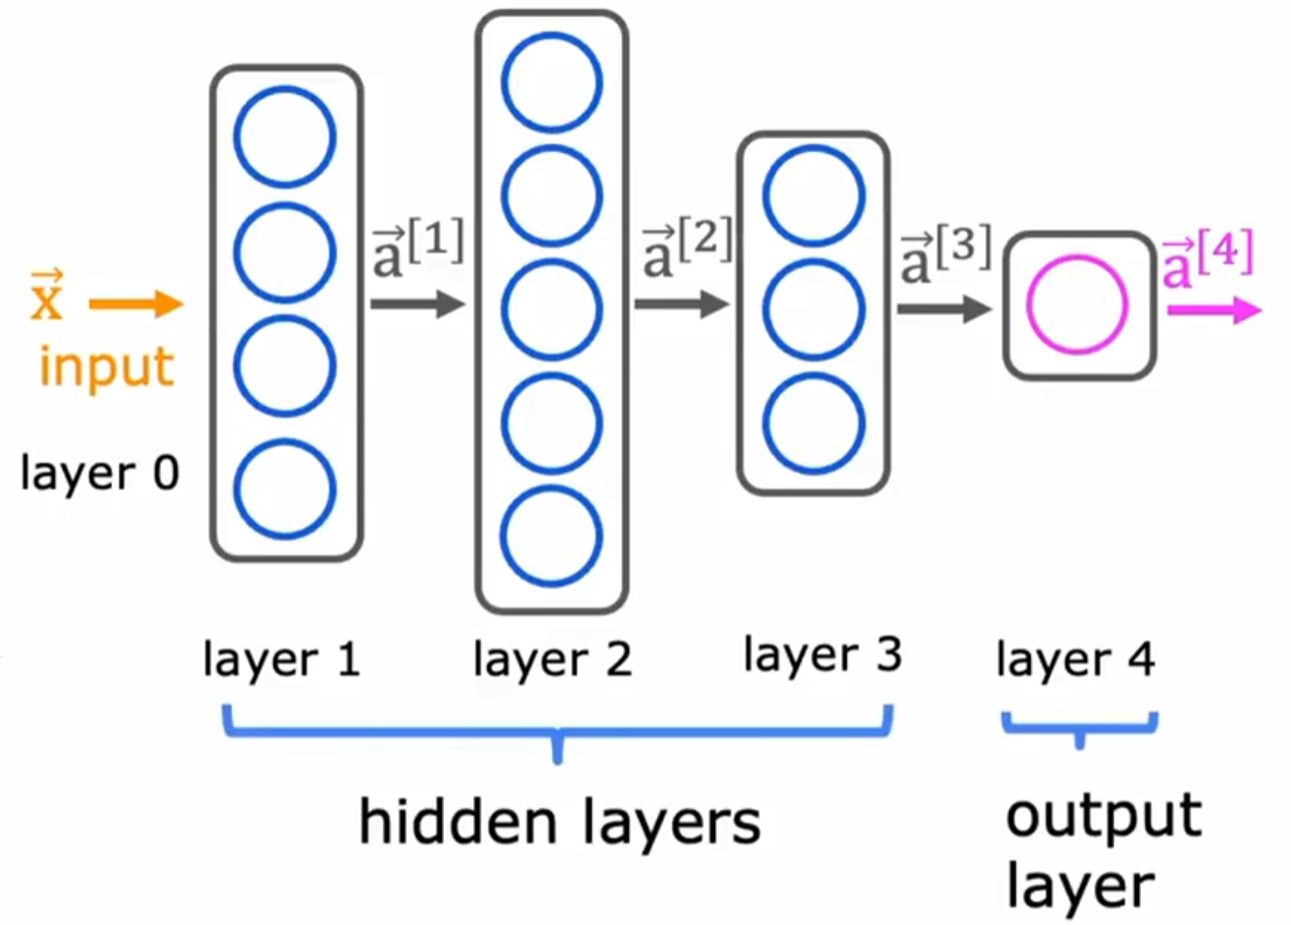
- 输入层:接收特征,不算"层数"
- 隐藏层:自动学习数据的中间特征表示(深度学习的"深度"就指隐藏层多)
- 输出层:按任务设计
NOTE
理论上:一个隐藏层 + 足够多的神经元 + 非线性激活,可以逼近任意连续函数。但"能逼近"不等于"容易训练",实践中用更深的网络换取参数效率。
以一个隐藏层的网络为例,前向传播(矩阵形式,
import matplotlib.pyplot as plt
import numpy as np
def load_coffee_data():
    """ Creates a coffee roasting data set.
        roasting duration: 12-15 minutes is best
        temperature range: 175-260C is best
    """
    rng = np.random.default_rng(2)
    X = rng.random(400).reshape(-1, 2)
    X[:, 1] = X[:, 1] * 4 + 11.5  # 12-15 min is best
    X[:, 0] = X[:, 0] * (285 - 150) + 150  # 350-500 F (175-260 C) is best
    Y = np.zeros(len(X))

    i = 0
    for t, d in X:
        y = -3 / (260 - 175) * t + 21
        if (t > 175 and t < 260 and d > 12 and d < 15 and d <= y):
            Y[i] = 1
        else:
            Y[i] = 0
        i += 1

    return (X, Y.reshape(-1, 1))

X, Y = load_coffee_data()
u = X.mean(axis=0)
sigma = X.std(axis=0)
X = (X - u) / sigma
print(f"Temperature Max, Min post normalization: {np.max(X[:,0]):0.2f}, {np.min(X[:,0]):0.2f}")
print(f"Duration    Max, Min post normalization: {np.max(X[:,1]):0.2f}, {np.min(X[:,1]):0.2f}")
print(X.shape, Y.shape)

neg_pos = np.where(Y == 0)
pos_pos = np.where(Y == 1)
plt.scatter(X[neg_pos, 0], X[neg_pos, 1], marker='x', c='r')
plt.scatter(X[pos_pos, 0], X[pos_pos, 1], marker='o', c='b')

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def my_dense(a_in, W, b):
    return sigmoid(a_in @ W + b)

def forward_prop(X):
    W1_tmp = np.array([[-8.93, 0.29, 12.9], [-0.1, -7.32, 10.81]])
    b1_tmp = np.array([-9.82, -9.28, 0.96])
    W2_tmp = np.array([[-31.18], [-27.59], [-32.56]])
    b2_tmp = np.array([15.41])
    A1 = my_dense(X, W1_tmp, b1_tmp)
    A2 = my_dense(A1, W2_tmp, b2_tmp)
    return A2

X_tst = np.array([
    [200,13.9],  # postive example
    [200,17]])   # negative example
X_tst = (X_tst - u) / sigma
predictions = forward_prop(X_tst)
print(predictions)
yhat = (predictions > 0.5).astype(int)
print(yhat)
plt.show()
反向传播 Back propagation
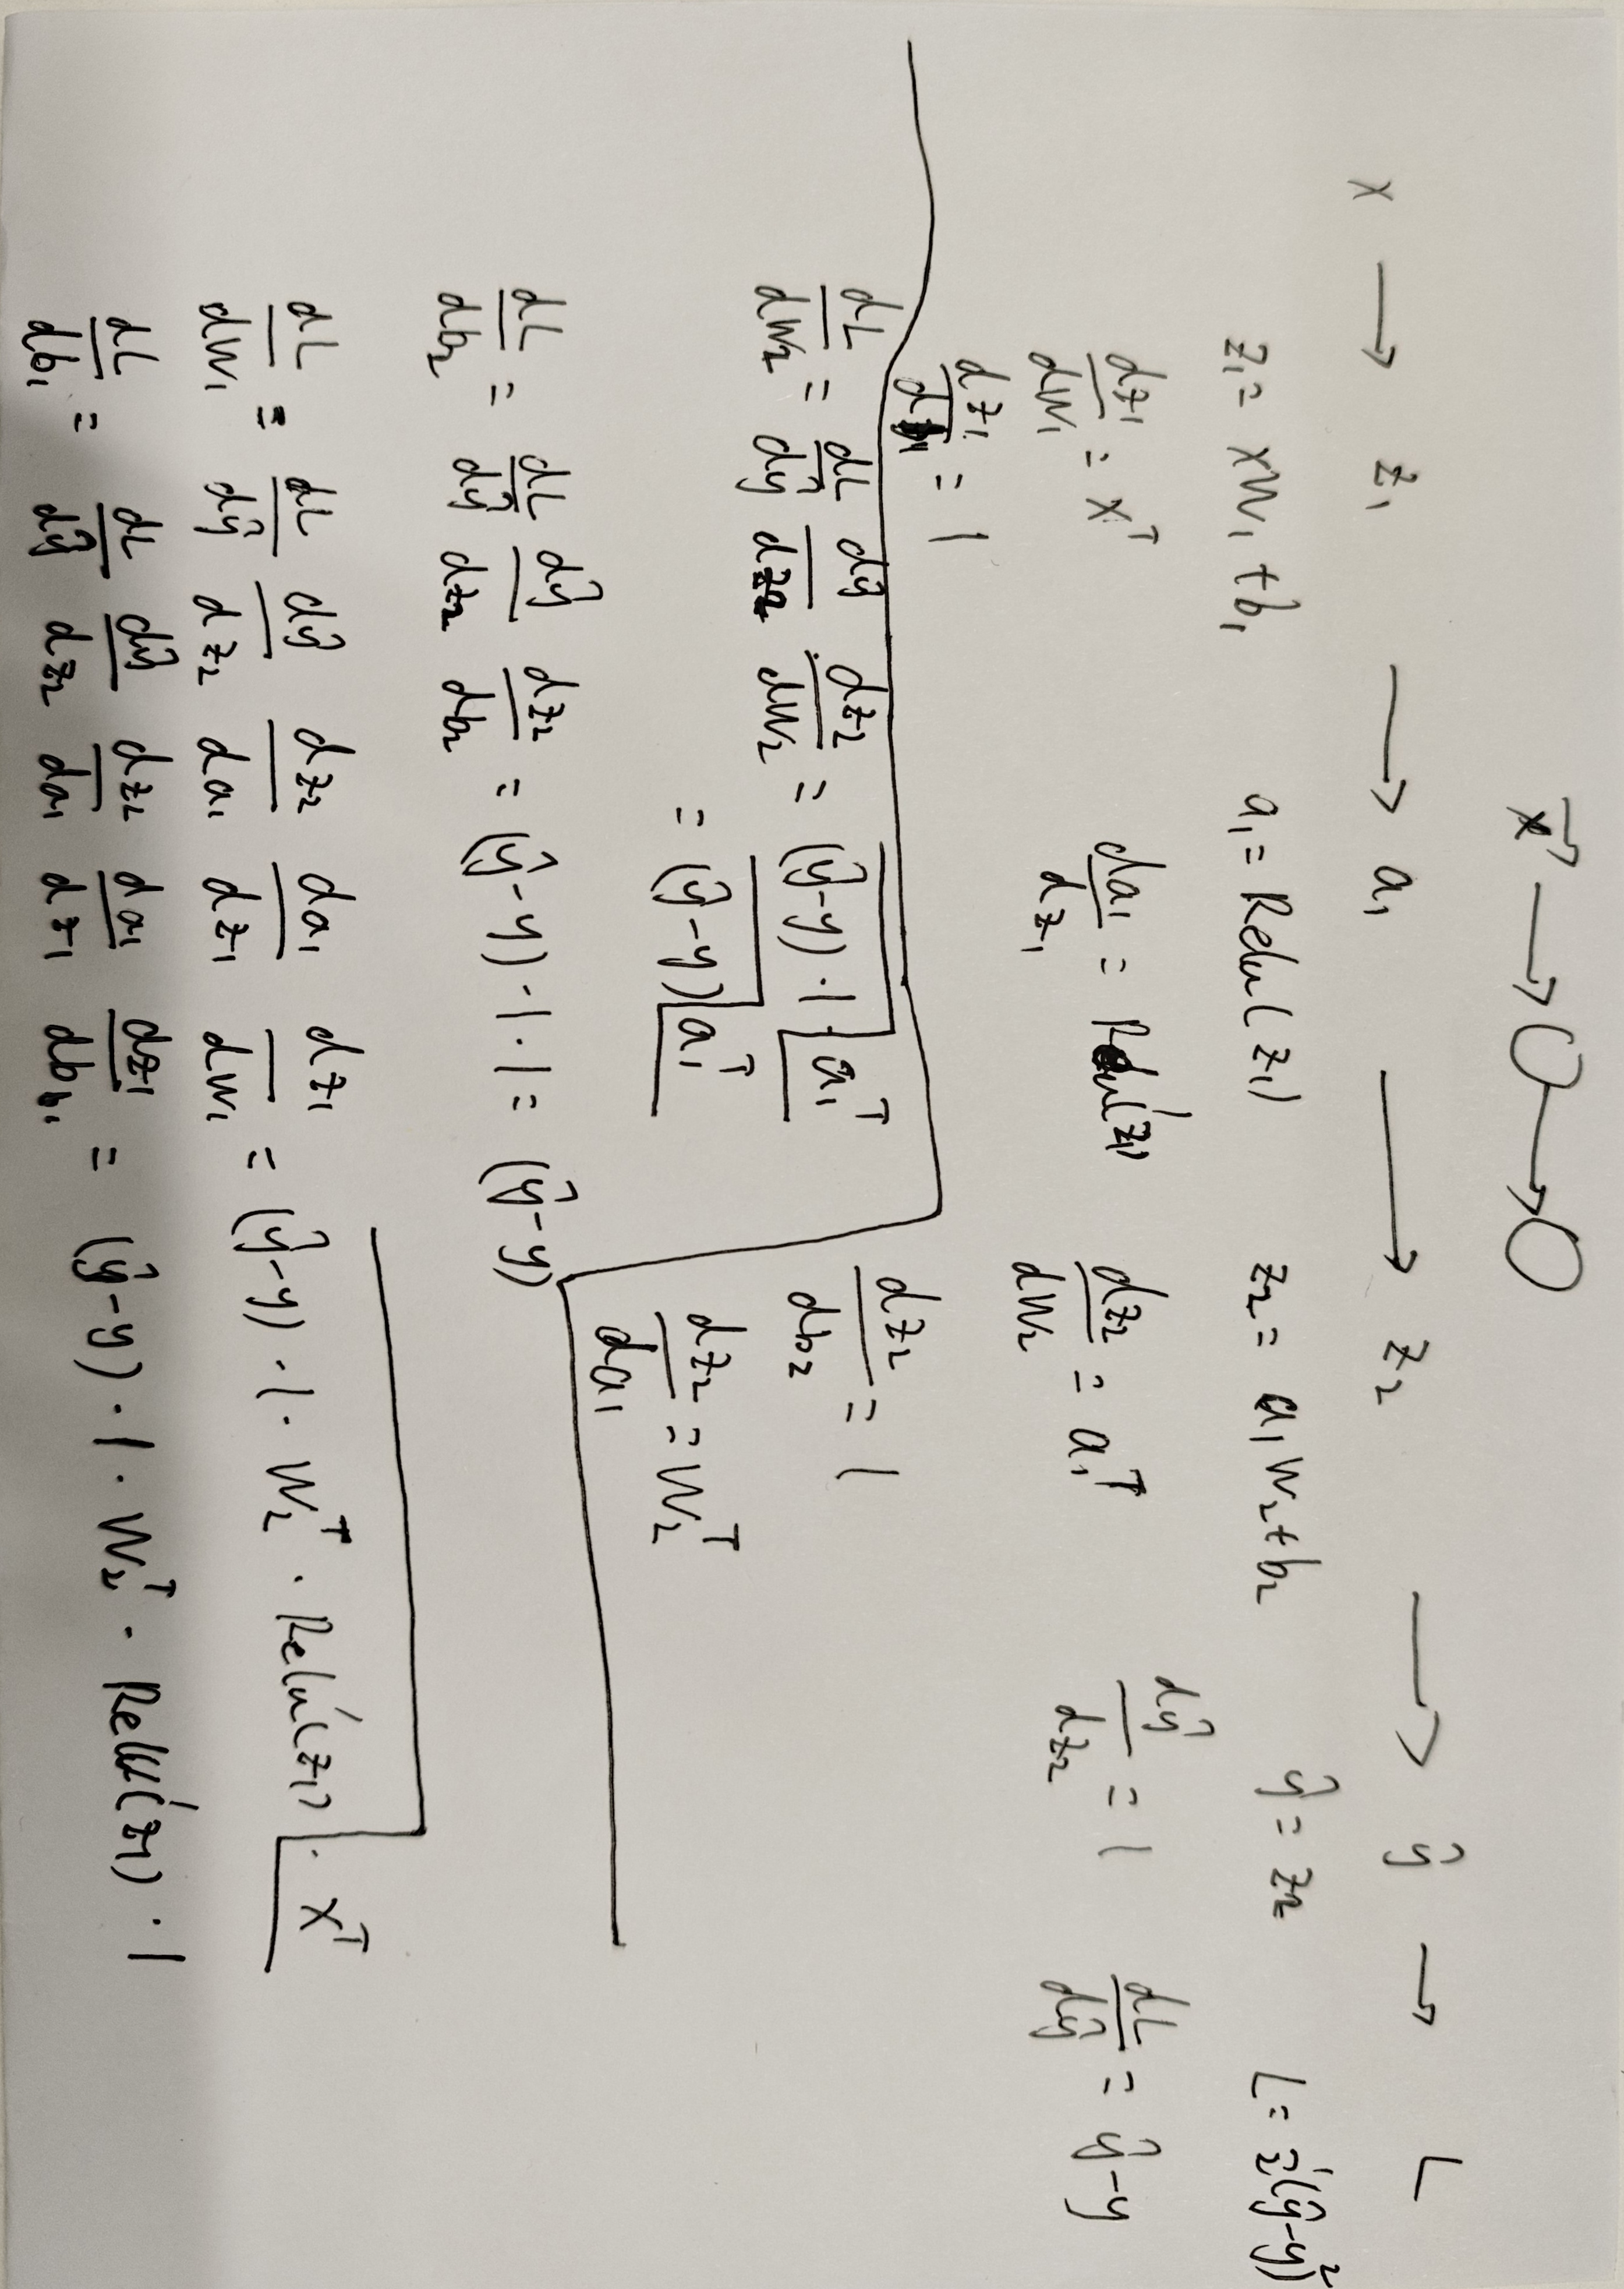
前向传播算出预测和损失;反向传播用链式法则从输出层往回,逐层算出每个参数对损失的梯度,然后用梯度下降更新。
前向传播(forward) → 计算损失(loss) → 反向传播(backward) → 参数更新(update)链式法则:
- 两层网络的标准反向传播公式(交叉熵 + softmax/sigmoid)
定义每层的误差项
规律:本层误差 = 后层误差"穿过"权重传回来 × 本层激活的导数;参数梯度 = 本层误差 × 本层输入。
代码实现
import matplotlib.pyplot as plt
import numpy as np


def load_coffee_data():
    pass # 同前向传播

X, Y = load_coffee_data()
u = X.mean(axis=0)
sigma = X.std(axis=0)
X = (X - u) / sigma
print(f"Temperature Max, Min post normalization: {np.max(X[:,0]):0.2f}, {np.min(X[:,0]):0.2f}")
print(f"Duration    Max, Min post normalization: {np.max(X[:,1]):0.2f}, {np.min(X[:,1]):0.2f}")
print(X.shape, Y.shape)

m, n = X.shape
J_history = []
# INPUT(m, 2) --> Hidden layer(3个神经元,ReLU) --> Output layer(1个神经元,Sigmoid+二元交叉熵)

W1 = np.array([[-8.93, 0.29, 12.9], [-0.1, -7.32, 10.81]])
b1 = np.array([-9.82, -9.28, 0.96])
W2 = np.array([[-31.18], [-27.59], [-32.56]])
b2 = np.array([15.41])

# --- 随机初始化,从头训练 ---
# np.random.seed(0)  # 固定随机种子,保证每次运行结果可复现
# W1 = np.random.randn(2, 3) * np.sqrt(2 / 2)  # He 初始化:ReLU 激活推荐 √(2/n_in)
# b1 = np.zeros(3)
# W2 = np.random.randn(3, 1) * np.sqrt(2 / 3)
# b2 = np.zeros(1)

def sigmoid(x):
    x = np.clip(x, -500, 500)
    return 1 / (1 + np.exp(-x))

def ReLU(x):
    return np.maximum(0, x)


def back_prop(X, Y, W1, b1, W2, b2, lr):
    # forward prop
    # (m,2) (2, 3)
    Z1 = X @ W1 + b1
    A1 = ReLU(Z1)
    # (m, 3) (3, 1)
    Z2 = A1 @ W2 + b2
    y_hat = sigmoid(Z2)

    y_hat = np.clip(y_hat, 1e-9, 1-1e-9)
    cost = -np.sum(Y * np.log(y_hat) + (1 - Y) * np.log(1 - y_hat)) / m
    J_history.append(cost)

    # back prop
    # (m, 1)
    dZ2 = y_hat - Y

    dW2 = (A1.T @ dZ2) / m
    db2 = np.mean(dZ2, axis=0)
    # db2_test = np.mean(dZ2, axis=0, keepdims=True)
    # print(b2, db2, db2_test)

    dZ1 = (dZ2 @ W2.T) * (Z1 > 0)
    dW1 = (X.T @ dZ1) / m
    db1 = np.mean(dZ1, axis=0)
    # print(b1, db1)

    W1 = W1 - lr * dW1
    b1 = b1 - lr * db1
    W2 = W2 - lr * dW2
    b2 = b2 - lr * db2
    return W1, b1, W2, b2

lr = 0.01
epochs = 1000

for _ in range(epochs):
    W1, b1, W2, b2 = back_prop(X, Y, W1, b1, W2, b2, lr)

plt.plot(J_history)
plt.xlabel("Epoch")
plt.ylabel("Cost")
plt.show()
训练常见问题
参数初始化
- 参数初始化0或相同值时所有神经元会永远学出相同特征(对称性无法打破)
- 常用:Xavier 初始化(适合 tanh)、He 初始化(适合 ReLU),按层宽缩放方差
梯度消失 / 梯度爆炸
- 反向传播连乘很多小导数 → 浅层梯度趋近 0,梯度消失**
- 对策:ReLU 激活、Batch Normalization、残差连接(ResNet)、合理初始化、梯度裁剪
过拟合
- Dropout:训练时随机"关掉"一部分神经元,强迫网络不依赖单个神经元
- L2 正则(weight decay)、早停(early stopping)、数据增强
优化器
SGD(Stochastic Gradient Descent,随机梯度下降)→ Momentum(动量加速)→ Adam(自适应学习率)
数据集
一般分为训练 / 验证 / 测试
- 训练集决定参数(
,梯度下降) - 验证集决定超参数(学习率、网络层数、正则化参数
),用来比较不同模型和选最终模型。训练集中训练到收敛,再在测试集中测试并选取最好的结果,也称交叉验证(Cross Validation) - 测试集:只允许在所有决策(选模型、调参)完成后,跑一次评估。任何"看测试集结果后回头改模型"的行为都会让测试集悄悄变成验证集,评估结果虚高。
高偏差与高方差
欠拟合(Under-Fitting)对应的模型是高偏差(high bias)
过拟合(Over-Fitting)对应的模型是高方差(high variance)
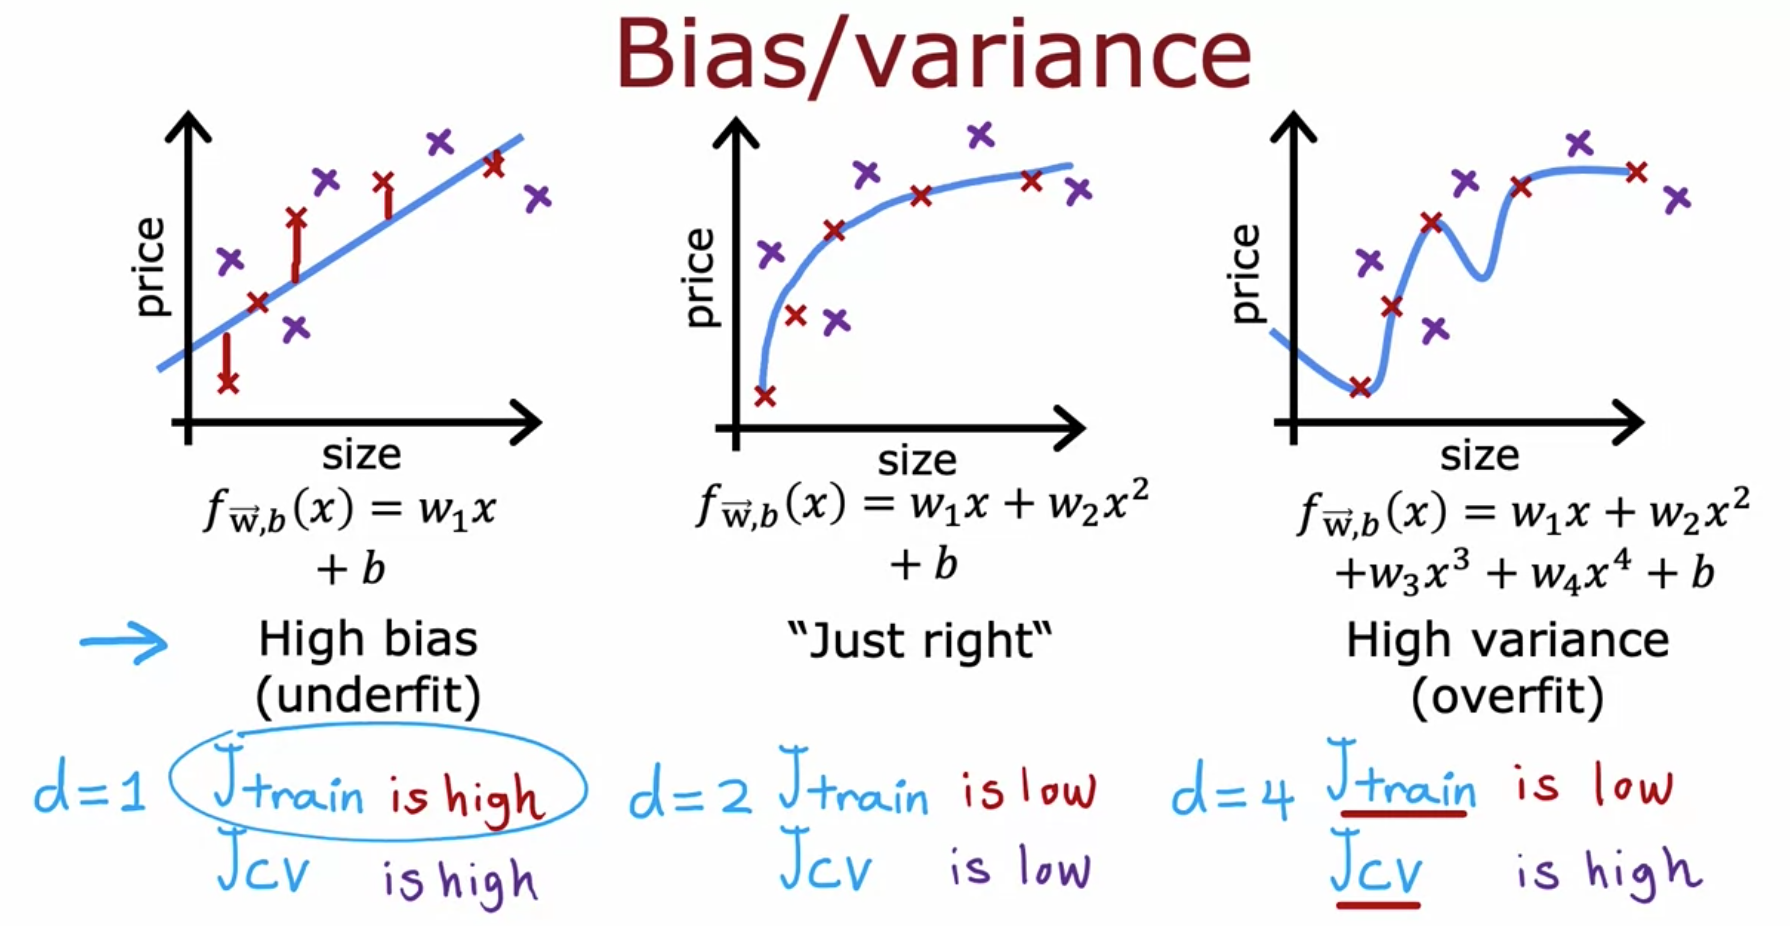
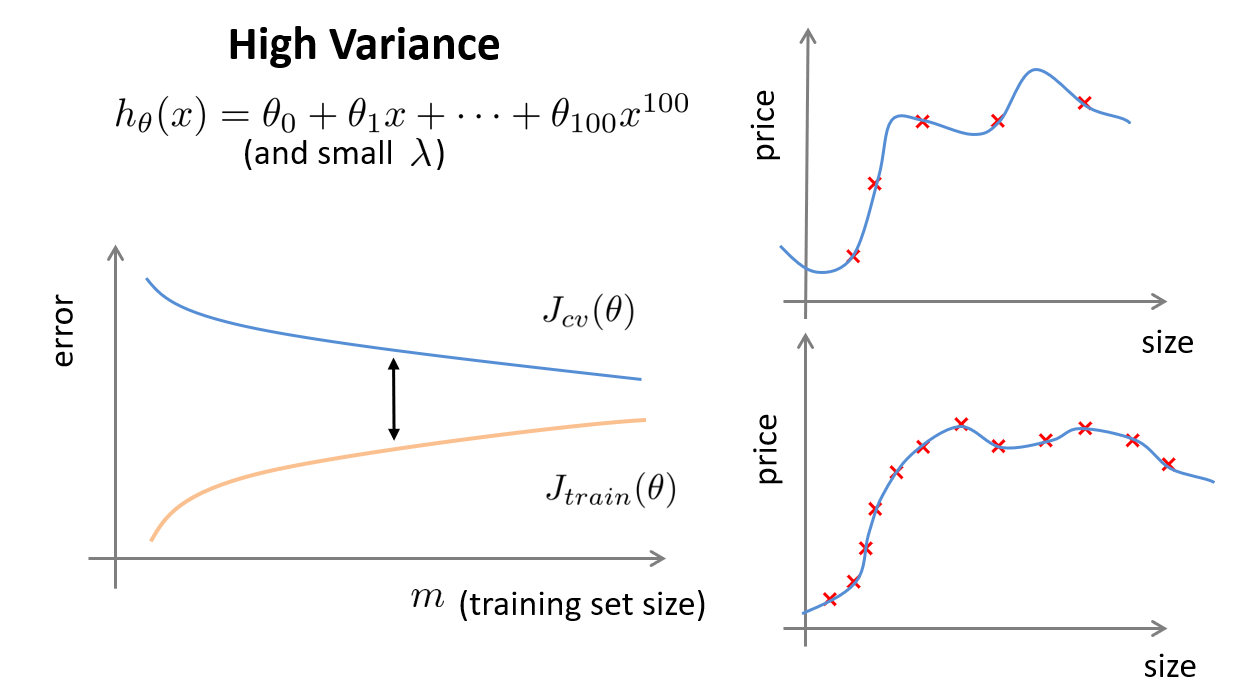
最左侧的图展示的是高偏差问题,此时模型无法捕捉训练数据中的规律。因此,训练误差和交叉验证误差都会很高。与之相对,最右侧的图展示的是高方差问题,模型对训练集发生了过拟合。所以,尽管它的训练误差很低,但在新样本上表现很差,交叉验证误差较高。理想的模型对应中间的图,该模型既能从训练集中有效学习,又能很好地泛化到未见过的数据。
以多项式回归为例,随着多项式系数的增加,我们从欠拟合逐渐过渡到过拟合,训练集上的代价函数
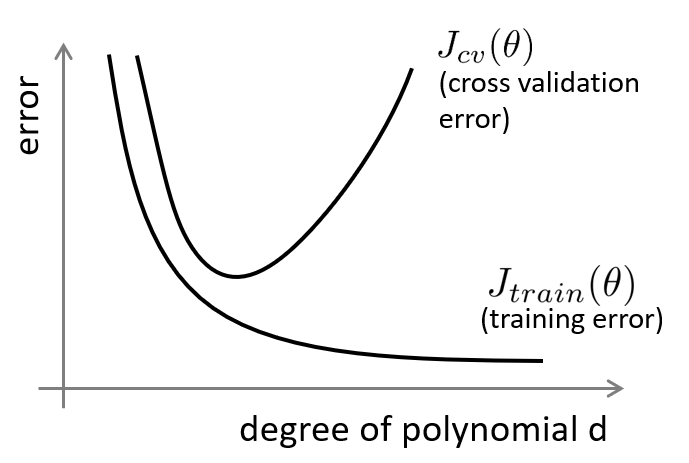
当
学习曲线
此外,作出学习曲线也有利于帮助我们分析模型拟合情况。学习曲线是误差函数关于「训练集规模」的曲线。
- 如果我们尝试用一条直线来拟合曲线数据,显然,此时模型欠拟合,无论训练集有多么大误差都不会有太大改观:
- 随着训练集增大,最终收敛在很大的误差,且远高于基线
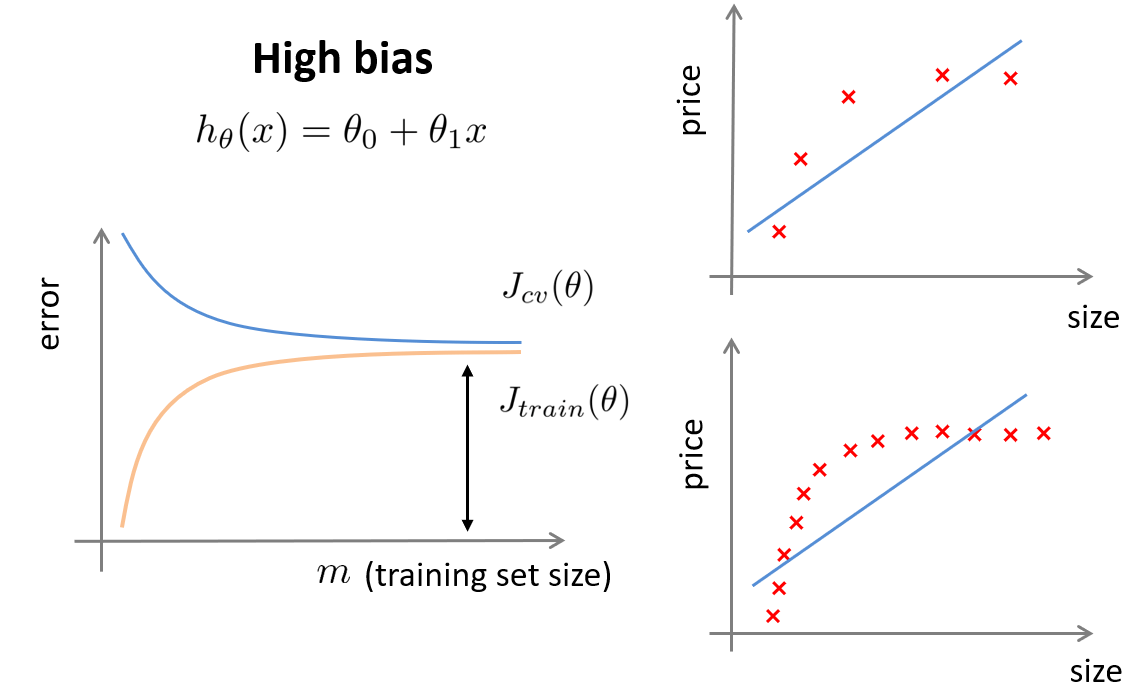
- 而如果我们使用一个非常高次的多项式模型,并且正则化非常小,显然,此时模型过拟合。可以看出,训练集不够时交叉验证集误差远大于训练集误差,此时增加更多数据可以提高模型的效果,最终误差收敛到基线附近
误差分析与评价
除了通过观察学习曲线判断拟合情况,还可以人工检查验证集预测出错的样本(Bad Cases),分析这些错误样本是否存在某种系统化的趋势。从而思考如何改进,通过加入不同特征、尝试不同模型、设计不同网络结构来针对性训练。
因此,快速开发出一个不完美但可用的模型是很有必要的,它可以指导你的下一步该怎么走,比起花费大量时间思考显然高效很多。当然,如果能有一个数值化的评价指标,那实验的进度也能大大加快。
类偏斜的误差度量 Skewed Classes
过去我们常用预测的准确率(Accuracy)或错误率(Error Rate)来评价一个分类模型,既适用于二分类任务,也适用于多分类任务。然而,Accuracy 却无法满足所有的分类需求,例如以下情形:
- 癌症患者识别任务,患者为正例,正常人为负例。显然患者的比例远小于正常人的比例,例如
,如果我们模型将所有样例都识别为正常人,那么该模型的 Accuracy 将高达 ,但显然这不是我们想要的结果。
这些任务的特点是类别分布极不均衡,即存在类偏斜问题(Skewed Class),在多分类任务中也被称为长尾分布问题(Long Tailed Distribution。构建一个混淆矩阵(Confusion Matrix)会很用,如下
| / | 实际为正例 | 实际为负例 |
|---|---|---|
| 预测为正例 | ||
| 预测为负例 |
定义精确率(Precision),也称查准率、精度,从预测结果角度出发,所有预测为正例
定义召回率(Recall),也称查全率,从实际结果角度出发,所有实际为正例
Precision 和 Recall 通常是一对矛盾、此消彼长的性能度量指标。一般来说,Precision 越高时,Recall 往往越低,反之亦然。因此精确率和召回率的权衡很重要。
以癌症患者识别任务为例,假设我们的算法会输出一个
为此,我们定义了一个统一的指标来衡量模型的召回率与精确率,即:
其中
对于一个模型来说,如果想要在精确率和召回率之间取得一个较好的平衡,最大化 F1 值是一个有效的方法。
如果我们有多个模型,通过固定模型后调整阈值大小,我们可以得到一系列精确率和召回率并绘制成一条曲线,而这条曲线就被称为 PR-曲线(Precision-Recall Curve)。较高的 PR-AUC(Area Under the Curve) 表示模型在不同分类阈值下,能够整体保持较好的 Precision-Recall 权衡。
聚类(Clustering)
无监督学习的数据不再包含标注的标签,即采用完全无标注的数据集。其中聚类问题属于无监督学习的范畴,其目的是在无标注的情况下将样本集划分为若干类。
聚类问题其本质是「根据样本之间的相似度,将数据进行归类」,由于没有显式的标签,唯一的依据就是样本之间的相似度。而相似度的度量方法,可以大致分为:
- 距离相似性度量:以欧式距离为代表的各种距离、余弦相似度等。
- 密度相似性度量:以 KL 散度为代表的各种熵。
- 连通相似性度量:以杰卡德指数为代表的各种统计量,在集合与图背景下更为常用。
由以上度量方法引申出的聚类算法也有很多:
- 基于划分的聚类:K-Means、K-Means++、Bisecting K-Means 等。
- 基于密度的聚类:DBSCAN、Mean Shift、OPTICS 等。
- 层次聚类:DIANA、AGNES、HDBSCAN、Agglomerative、Divisive 等。
- 基于图的聚类:Chinese Whisper、CDP 等。
聚类评价指标
如何评价一个无监督的算法?和有监督类似,需要一个测试集,但无监督算法的测试集则有无标签都可以。针对数据有类别标签的情况,最常用的评价指标有两种:
- 均一性:每个聚簇中正确分类的样本数占该聚簇总样本数的比例和,类似于精确率,如果一个簇中只包含一个类别的样本,则称其满足均一性。
- 完整性:每个聚簇中正确分类的样本数占该类型的总样本数比例的和,类似于召回率,同类别样本被归类到相同簇中,则称其满足完整性。
同样,将上述二者加权平均,就能得到类似
- 调节兰德系数(Adjusted Rand index,ARI):计算聚类结果与实际划分的重叠程度,重叠程度越高表示聚类效果越好。
- 归一化互信息(Normalized Mutual Information,NMI):计算聚类结果的簇内互信息,值越大表示聚类结果越相近,效果越好。
对于无类别标签的情况,最常用的指标是轮廓系数(Silhouette Coefficient),结合了内聚度(Compactness)和分离度(Separation)两种因素。简单来说,就是希望簇内样本尽量相近,簇间样本尽量相远。
K-Means
K-Means 算法目的在于寻找最优的
如果已知每个样本点的所属类,那很容易就能算出中心(即质心)。如果已知每个类的中心,那么也很容易进行分类(按距离归类)。通过交替迭代计算,直到收敛,算法如下。
算法
随机初始化
重复执行直到聚类中心不再改变:
将样本点分配到聚类中心
对于
到 :
:= 与 距离最近的聚类中心的索引(从 1 到 ) 更新聚类中心
对于
到 :
:= 分配给第 个聚类的所有点的平均值(均值)
:聚类的数量,即需要将数据划分为多少个簇。 :第 个聚类中心(质心),表示该簇当前的中心位置。 :样本总数,即数据集中一共有多少个样本点。 :第 个样本点。 :第 个样本所属聚类的编号,其取值范围为 到 。 :聚类索引,用于表示第 个聚类。 :当前被分配到第 个簇的所有样本点的平均值。
优化目标
最小化各数据点到它所属于的聚类中心的距离,
2、3 两个步骤都是在减小这个代价:第 2 步减小
初始化K均值
- 为了避免 K-means 因随机初始化不同而得到较差的局部最优解,可以进行多次随机初始化,并选择代价函数最小的一次结果。
对于
随机初始化 K-means 的聚类中心,从训练样本中随机选择
个样本作为初始聚类中心。 运行 K-means 算法,得到:
计算代价函数(失真函数):
重复多次后,选择代价函数
- 随机初始化若两个质心都落在同一堆里,收敛到很差的局部最优。K-Means++ 改进初始化,其核心思想是:逐个选取聚类中心,且其他距离现有中心越远的样本点越有可能被选为下一个聚类中心。
首先随机选取第一个初始聚类中心
计算每个样本与当前已有聚类中心之间的最短距离,用
表示,则该样本被选取为下一个聚类中心的概率为 ; 重复第 2 步,直到选出
个初始聚类中心。
其中概率
注意,K-Means++ 选点是基于概率,而非直接选择距离最远的点,因为这样很容易陷入离群点,导致一个离群点被单独聚为一类。
选择聚类数量
在实践中,我们可以任取
绘制出代价函数关于簇数的变化曲线:
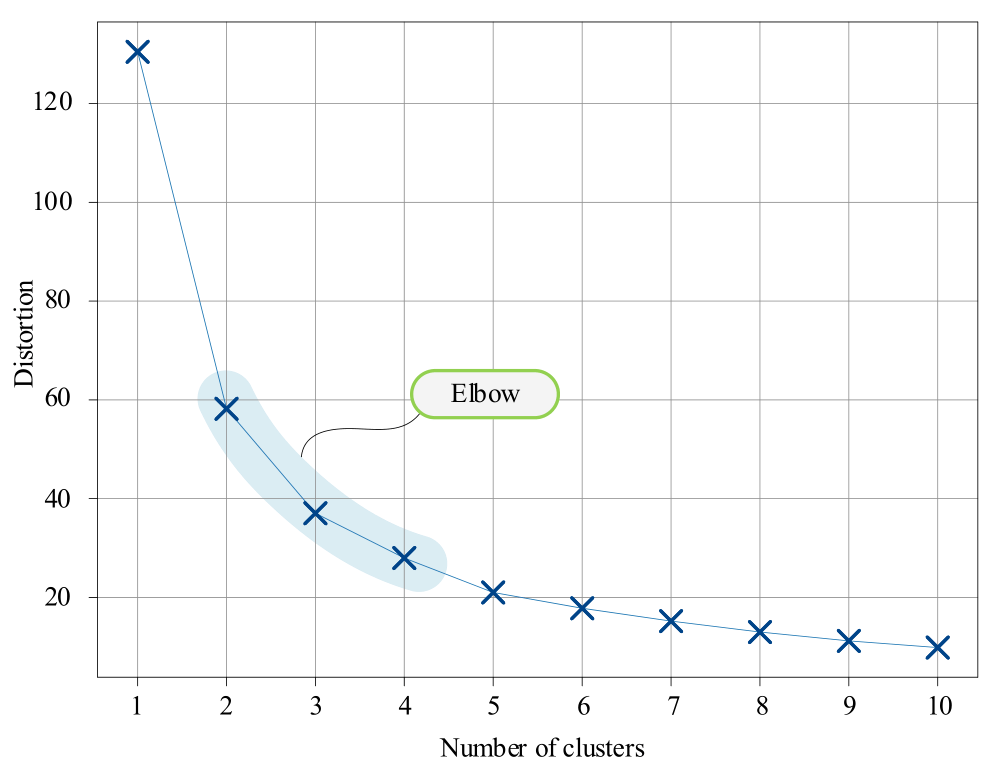
观察上图,我们发现当
轮廓系数:
实际使用中通常会根据下游目标的表现和业务需求来综合评估选择合适的簇数
代码
from scipy.io import loadmat
import numpy as np
import matplotlib.pyplot as plt


def J(X, c, mu):
    tmp = mu[c]
    m = X.shape[0]
    return np.sum((X - tmp)**2) / m

def K_Means(X, K, times=100):
    (m, n) = X.shape

    best_cost = np.inf
    best_mu = np.empty((K, n))
    best_c = np.empty(m)
    for _ in range(times):
        mu = X[np.random.choice(range(m), K, replace=False)]
        c = np.empty(m, dtype=int)
        while True:
            new_mu = np.zeros((K, n))
            cnt = np.zeros(K)
            for i in range(m):
                c[i] = np.argmin(np.linalg.norm(X[i] - mu, axis=1))
                new_mu[c[i]] += X[i]
                cnt[c[i]] += 1

            new_mu[cnt != 0] = new_mu[cnt != 0] / cnt[cnt != 0].reshape((-1,1))
            new_mu[cnt == 0] = X[np.random.choice(range(m), len(cnt[cnt == 0]), replace=False)]
            if (mu == new_mu).all():
                break
            mu = new_mu

        cost = J(X, c, mu)
        if cost < best_cost:
            best_cost = cost
            best_mu = mu
            best_c = c

    return best_cost, best_mu, best_c

data = loadmat("./dataset/ex7data2.mat")
print(data.keys())
X = data["X"]

cost, mu, c = K_Means(X, 3, 100)

plt.xlabel('x1')
plt.ylabel('x2')
plt.plot(X[c==0][:, 0], X[c==0][:, 1], 'o', color='blue', markerfacecolor='none')
plt.plot(X[c==1][:, 0], X[c==1][:, 1], 'o', color='green', markerfacecolor='none')
plt.plot(X[c==2][:, 0], X[c==2][:, 1], 'o', color='red', markerfacecolor='none')
# plt.plot(X[c==3][:, 0], X[c==3][:, 1], 'o', color='black', markerfacecolor='none')
plt.plot(mu[0, 0], mu[0, 1], '*', color='blue', ms=10)
plt.plot(mu[1, 0], mu[1, 1], '*', color='green', ms=10)
plt.plot(mu[2, 0], mu[2, 1], '*', color='red', ms=10)
# plt.plot(mu[3, 0], mu[3, 1], '*', color='black', ms=10)
plt.plot([], [], '*', color='black', ms=10, label='cluster centroid')
plt.legend()
plt.show()
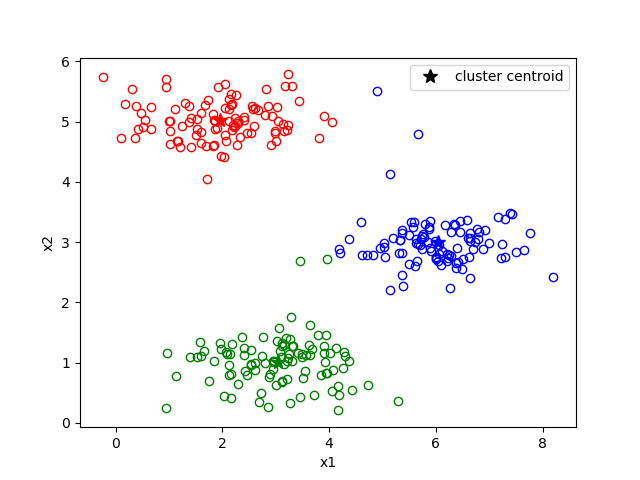
结果如下
DBSCAN
DBSCAN 是一种经典的基于密度的聚类算法,全称是 Density-Based Spatial Clustering of Applications with Noise,中文通常称为“具有噪声的基于密度的空间聚类算法”。
算法
- 选定一个数据点。
- 查看这个点周围一定范围内有多少个邻居。
- 如果邻居足够多,就认为这个点处于高密度区域。
- 从这个点出发,继续寻找相邻的高密度区域。
- 将相互连接的高密度区域扩展为一个完整的簇。
- 无法归入任何簇的点,最终可能成为噪声点。
- ε(Epsilon):邻域半径,定义一个点周围多大的范围属于它的邻域
- MinPts:最小邻域点数,一个点的 ε 邻域中,至少需要包含多少个数据点,才能被认定为核心点。
代码
import sys
from collections import deque

eps, min_samples, x = input().split()
eps = float(eps)
min_samples, x = int(min_samples), int(x)

points = []
for i in range(x):
    nums = list(map(float, input().split()))
    points.append(nums)


def dbscan(points, eps, min_pts):
    n = len(points)
    neighbors = [[] for _ in range(n)]
    # 计算领域
    for i in range(n):
        for j in range(n):
            dist = 0
            for x, y in zip(points[i], points[j]):
                dist += (x - y) ** 2
            if dist <= eps ** 2:
                neighbors[i].append(j)

    st = [-1] * n
    # print(neighbors)
    c = 0
    for i in range(n):
        if st[i] != -1:
            continue

        cur_ne = neighbors[i]
        # 可能为边界点或噪声点
        if len(cur_ne) < min_pts:
            continue

        st[i] = c
        que = deque(cur_ne)
        while que:
            a = que.popleft()
            if st[a] != -1:
                continue
            st[a] = c
            if len(neighbors[a]) >= min_pts:
                que.extend(neighbors[a])
        c += 1
        # print(st)
    return st

label = dbscan(points, eps, min_samples)
clu = set(label) - {-1}
cnt_nos = label.count(-1)
print(f"{len(clu)} {cnt_nos}")
异常检测(Anomaly Detection)
异常检测的特点在于其假设样本特征服从高斯分布(Gaussian Distribution),而异常点通常偏离正常数据,且可能性较低。
传统的异常检测通过手工选择特征,并假设这些特征都服从高斯分布(正态分布)
其中:
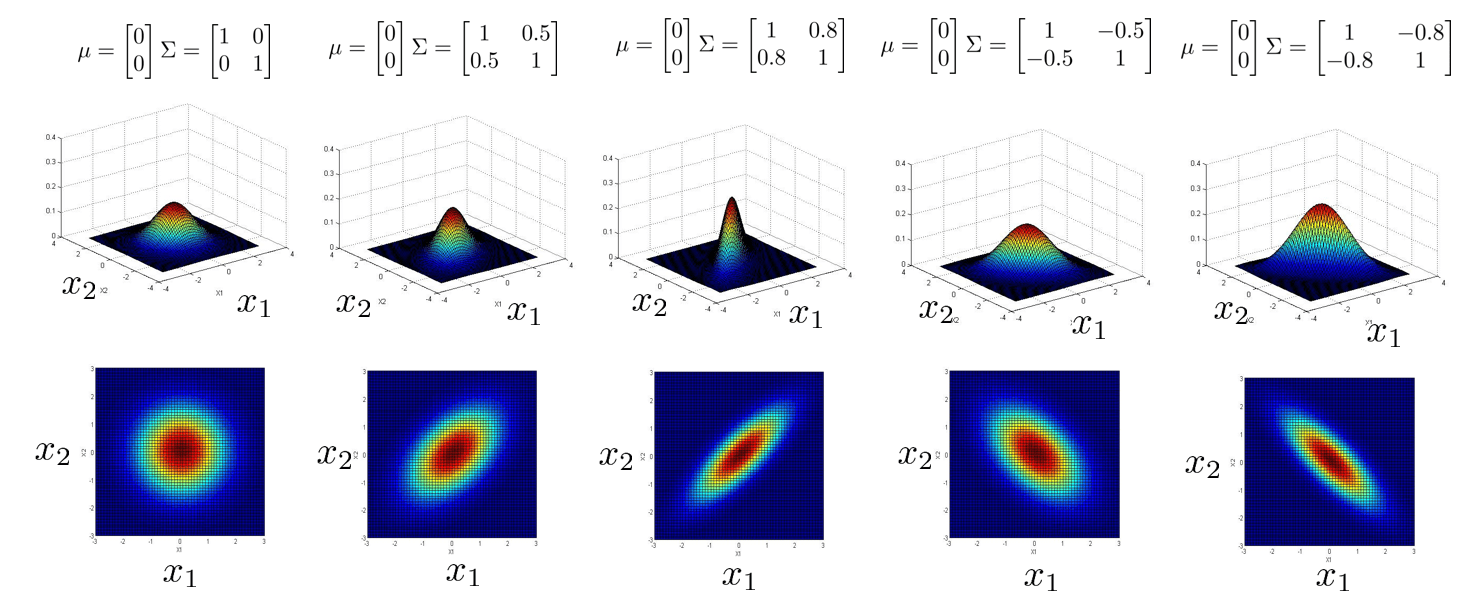
是样本均值,代表分布的中心; 是样本方差,代表样本偏离中心的程度, 越小,概率密度曲线就越瘦高; - 概率密度函数满足:
多元高斯分布
一个样本往往含有多个特征,多个特征组成的分布就是多元高斯分布(Multivariate Gaussian Distribution)。通常,我们朴素地假设
而对于其中的指数部分,可以表示为矩阵乘法的形式:
- 如果各特征相互独立,那么协方差矩阵为对角矩阵:
- 我们假设“各个特征互不相关/独立”,所以
是对角矩阵。但真正的一般多元高斯分布不要求特征独立。如果特征之间存在相关性, 中就会出现非零的非对角元素
算法
选择
个你认为能够反映异常样本的特征 。 拟合参数:
,对于第 个特征:
- 给定一个新的样本
,计算其概率 :
如果:
特征选择
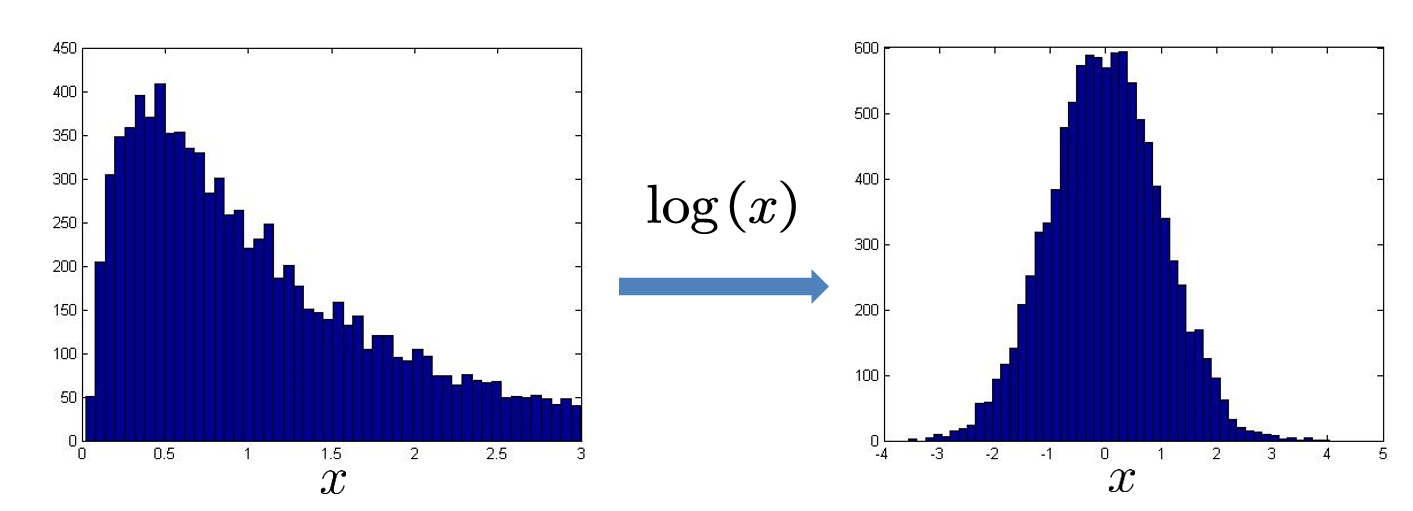
异常检测假设特征符合高斯分布,如果数据的分布不是高斯分布,我们通常先将数据转换成高斯分布。通常需要先画出特征分布的直方图,如果数据呈现偏态分布(Skewed Distribution)
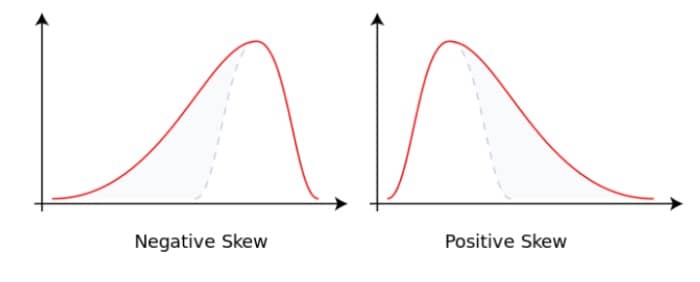
常用的转换方式有:对数变换、指数(平方根、倒数)变换、正反旋变换等
训练和验证
如果我们有标注过的数据(标注是否异常),则可以将数据划分为训练集、验证集和测试集。
- 训练集包含大部分正常数据,并据此构建出正态分布模型;
- 验证集和测试集包含正常和异常数据;
- 根据验证集的结果调整参数 ,最后在测试集上进行测试。
此外,由于异常检测数据集通常分布不均(正常数据远远多于异常数据),所以实验指标应该取
误差分析
在通过上述流程后,如果模型效果仍然不好,则需要进行误差分析。
一个常见的问题是:一些异常的数据可能也会有较高的
代码
import numpy as np
from scipy.io import loadmat
from scipy.stats import multivariate_normal
from sklearn.metrics import f1_score
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt

data = loadmat("./dataset/ex8data1.mat")
print(data.keys())

X = data['X']
Xval = data['Xval']
yval = data['yval']
m, n = X.shape

Xval, Xtest, yval, ytest = train_test_split(Xval, yval,test_size=0.5)

Xmeans = X.mean(axis=0)
Xcov = (X - Xmeans).T @ (X - Xmeans) / m
normal = multivariate_normal(Xmeans, Xcov)

pdfX =  normal.pdf(X)
pdfXval = normal.pdf(Xval)
pdfXtest = normal.pdf(Xtest)

best_f1, best_eps = 0, 0
for eps in np.linspace(pdfXval.min(), pdfXval.max(), 1000):
    f1 = f1_score(yval, pdfXval < eps)
    if f1 > best_f1:
        best_f1 = f1
        best_eps = eps

print(f"best eps: {best_eps}")
print(f"f1 on test set: {f1_score(ytest, pdfXtest < best_eps)}")

plt.plot(X[:, 0], X[:, 1], 'x', color='blue', alpha=0.5)
plt.plot(X[pdfX < best_eps, 0], X[pdfX < best_eps, 1], 'o', color='red', ms=10, markerfacecolor='None')
plt.show()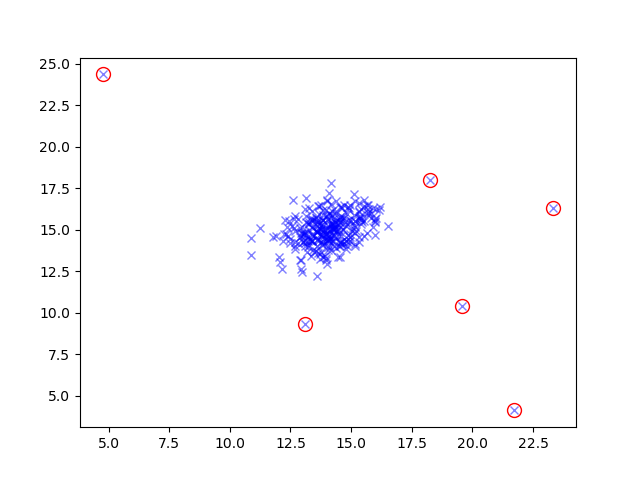
降维(Dimensionality Reduction)
主成分分析 Principal Component Analysis
推导
目标是找一个最优的
设样本
由于正交变换不改变向量长度,
若数据矩阵
接下来对
因此 PCA 的最优
实际 PCA 一般先对数据中心化,所以
算法步骤
计算矩阵
或者样本的协方差矩阵 进行奇异值分解,得到奇异向量
选取前
个奇异向量作为降维后的空间的基向量,构成基变换矩阵 对于原数据
,取 为其降维后的数据。更简单的表达是取 ,则 是降维后的数据集。
PCA 的算法过程中完全无超参数参与,不需要人为进行干预,最后的结果只与数据有关。这既是优点也是缺点,缺点在于难以利用已有先验进行额外的干预。
重建压缩数据
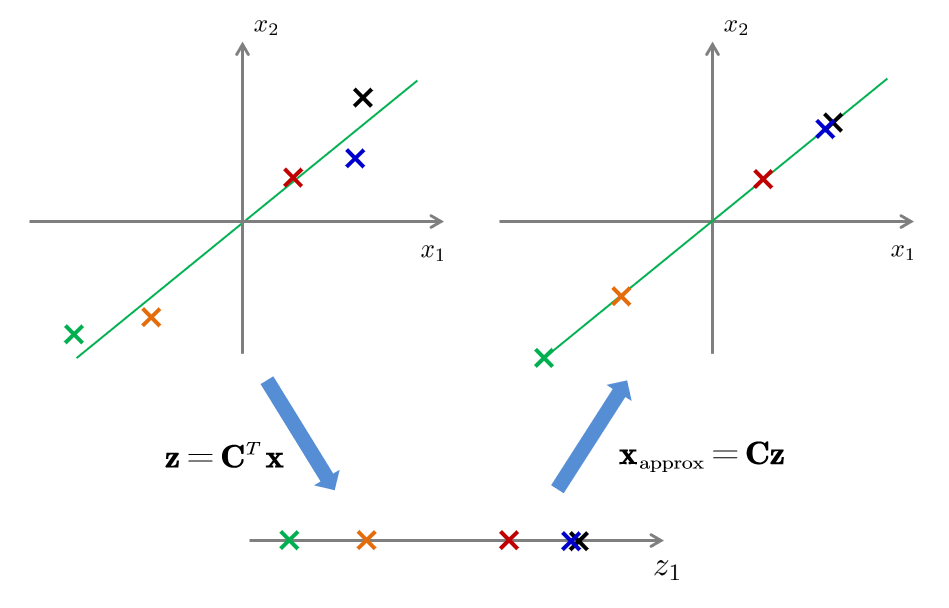
作为一种压缩算法,主成分分析也有解压缩的过程,将低维数据还原到高维数据的近似值,假设我们有压缩后的数据
主成分数量的选择
定义一个平均误差为:
则一般的,我们会选择最小的
并称之为「99% 的方差得以保留」,这样能使得丢失的信息最小化。
此外,上述式子看起来并不好计算,但可以证明,对于给定的
由于奇异值衰减非常快,
代码
import matplotlib.pyplot as plt
from scipy.io import loadmat
import numpy as np

data = loadmat('./dataset/ex7data1.mat')
X = data['X']
print(data.keys())
print(X.shape)

def PCA(X, dim = -1):
    X_mean = X.mean(axis=0)
    X_std = X.std(axis=0)
    X_norm = (X - X_mean) / X_std

    U, S, V = np.linalg.svd(X_norm.T @ X_norm)

    if dim == -1:
        dim = 1
        while S[:dim].sum() / S.sum() < 0.99:
            dim = dim + 1

    # (m, k)
    Z = X_norm @ U[:, :dim]
    Xapprox = (Z @ U[:, :dim].T) * X_std + X_mean
    return Z, Xapprox

Z, Xapprox = PCA(X, dim=1)
plt.xlabel('x1')
plt.ylabel('x2')
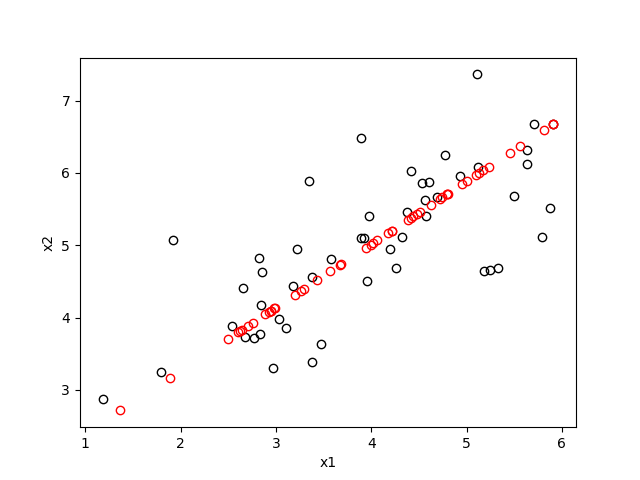
plt.plot(X[:, 0], X[:, 1], 'o', color='black', markerfacecolor='none')
plt.plot(Xapprox[:, 0], Xapprox[:, 1], 'o', color='red', markerfacecolor='none')
plt.show()